
Pamięć agentów AI to to, co pozwala agentowi przenieść coś z jednego kroku lub jednej sesji do następnej. Sam model językowy nie pamięta niczego między wywołaniami. Cokolwiek wydaje się pamiętać, zostało wpisane z powrotem do promptu przez Twój kod. To, jak przechowujesz i pobierasz ten materiał, decyduje o tym, co agent może przywołać, jak szybko i przy jakim koszcie na turę.
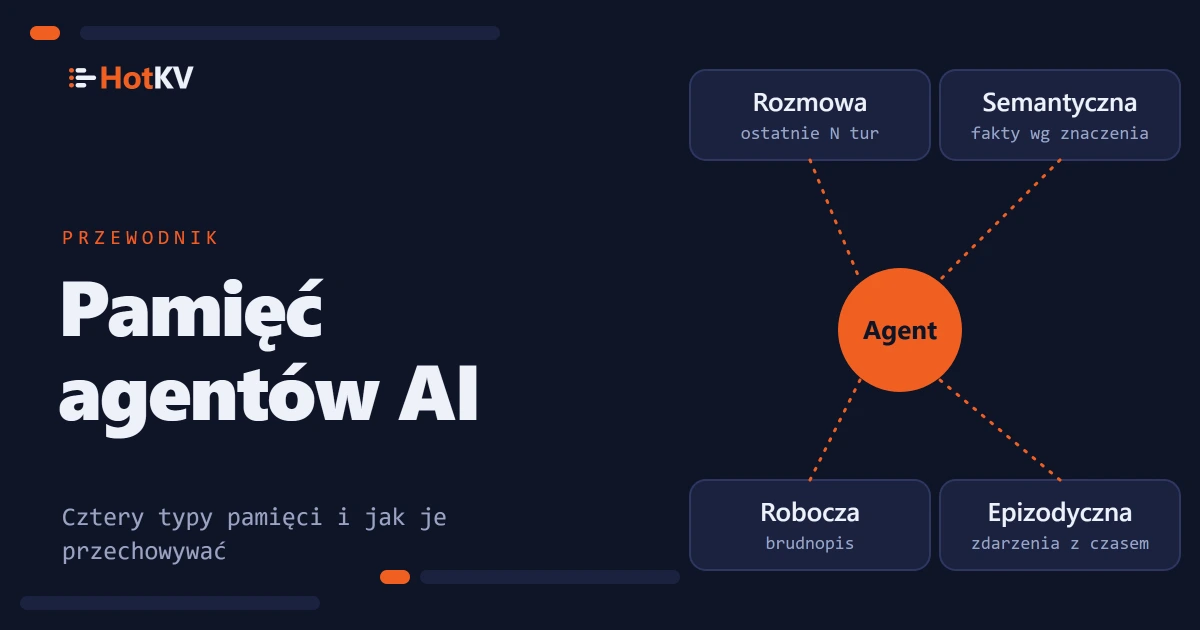
W skrócie. Agenci potrzebują czterech rodzajów pamięci: krótkiego okna konwersacji, długoterminowych faktów znajdowanych według znaczenia, brudnopisu dla zadania w toku i dziennika tego, co się wydarzyło. Każdy ma inny kształt, czas życia i sposób wyszukiwania, więc jedna tabela pamięci żadnemu z nich dobrze nie odpowiada. HotKV przechowuje wszystkie cztery w jednym silniku w pamięci, za pomocą poleceń
AMEM.*. Zmierzyliśmy cache i wyszukiwanie wektorowe HotKV, a nie pamięć agentów, więc ten artykuł wyjaśnia projekt i nie obiecuje żadnego przyspieszenia.
Dlaczego okno kontekstu to nie pamięć
Okno kontekstu to tekst, który wysyłasz z każdym żądaniem. Ma limit rozmiaru, za wszystko, co w nim jest, płacisz tokeny wejściowe w każdej turze, i znika, gdy sesja się kończy. Nie da się go też przeszukiwać. Jeśli agent potrzebuje jednego faktu sprzed trzech tygodni, wklejenie całej historii nie jest odpowiedzią.
Pamięć to warstwa, która decyduje, co trafi do okna jako następne. Zachowuje ostatnie tury i znajduje te nieliczne starsze fakty, które mają znaczenie. Przechowuje stan bieżącego zadania i zapisuje, co agent zrobił. Badacze opisują agentów w podobny sposób. Framework CoALA autorstwa Sumersa, Yao, Narasimhana i Griffithsa oddziela pamięć roboczą od długoterminowej pamięci epizodycznej, semantycznej i proceduralnej.
Cztery typy pamięci agentów AI
Cztery magazyny HotKV pokrywają większość tego samego obszaru, dostosowanego do tego, co musi zbudować aplikacja. Pamięć proceduralna, czyli know-how zawarte w kodzie i promptach agenta, zwykle żyje w Twoim repozytorium lub rejestrze promptów i nie jest osobnym magazynem.
Pamięć konwersacyjna
To krótkoterminowy zapis jednej sesji. Wiadomości mają rolę (system, user, assistant lub tool). Siedzą w ograniczonym oknie przesuwnym, więc najstarsze tury wypadają po osiągnięciu limitu. Odpowiada na jedno pytanie. Co powiedziano ostatnio? W HotKV to AMEM.CONV.CREATE, AMEM.CONV.APPEND i AMEM.CONV.WINDOW.
Pamięć semantyczna
Pamięć semantyczna to wiedza długoterminowa zapisana jako fakty z wektorem embeddingu. Agent przywołuje je według znaczenia, a nie klucza. Opiera się na indeksie wektorowym HNSW, takim samym jak ten, który napędza wyszukiwanie wektorowe. AMEM.SEM.STORE zapisuje fakt, a AMEM.SEM.RECALL zwraca najlepsze dopasowania z wynikiem podobieństwa. Tu należą dokumenty, preferencje użytkowników i wyuczone poprawki.
Pamięć robocza
Pamięć robocza to brudnopis dla zadania w toku, płaski zestaw kluczy i wartości ograniczony do sesji. Przechowuje bieżący krok, obsługiwane zgłoszenie lub wynik częściowy. Powinna zniknąć, gdy zadanie się kończy. AMEM.WORK.SET przyjmuje czas życia właśnie z tego powodu.
Pamięć epizodyczna
Pamięć epizodyczna to dziennik zdarzeń ze znacznikami czasu, tylko do dopisywania, taki jak podjęte działanie, dokonana obserwacja lub podjęta decyzja. Pozwala agentowi lub osobie go przeglądającej zapytać, co się stało i kiedy. AMEM.EPIS.LOG zapisuje zdarzenie, a AMEM.EPIS.QUERY odczytuje je z powrotem według typu i zakresu czasu.
Pamięć agentów AI w praktyce
Liczą się dwie rzeczy. Jak zapisujesz do pamięci i co odczytujesz z powrotem w każdej turze.
Zapisywanie pamięci poleceniami
Oto agent obsługi klienta prowadzący jedną rozmowę. Fikcyjny tekst polityki i trzyliczbowe wektory służą tylko za ilustrację. Prawdziwy model embeddingów tworzy wektory po 768 lub 1536 liczb, a przestrzeń nazw tworzysz z tym wymiarem.
AMEM.CONV.CREATE session-42 WINDOW 50 TTL 86400
AMEM.CONV.APPEND session-42 user "My invoice shows the wrong VAT number."
AMEM.WORK.SET session-42 ticket "INV-1932" TTL 3600
AMEM.EPIS.LOG agent-support action "Looked up invoice INV-1932"

AMEM.SEM.CREATE support-kb 3
AMEM.SEM.STORE support-kb vat-policy "VAT details can be corrected within 30 days." 0.1 0.2 0.3
AMEM.SEM.RECALL support-kb 3 0.1 0.2 0.3
AMEM.CONV.WINDOW session-42 10
W każdej turze agent odczytuje ostatnie okno i przywołuje kilka faktów pasujących do pytania. Sprawdza swoją notatkę roboczą i buduje prompt z tych elementów. Po działaniu zapisuje zdarzenie. Nic w tej pętli nie potrzebuje całej historii.
Odczyt pamięci w każdej turze
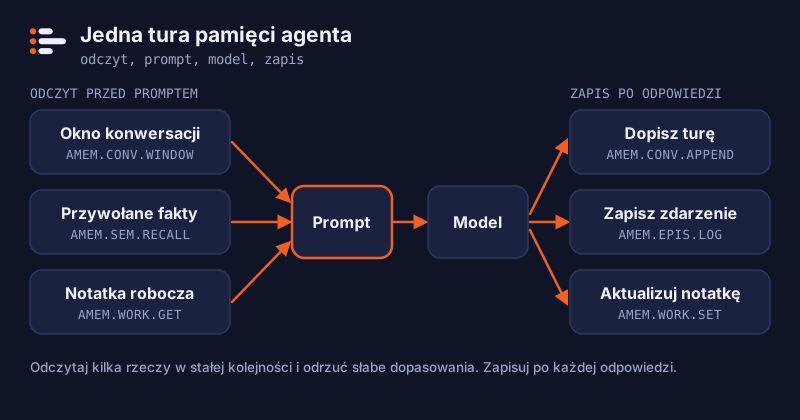
Zapisywanie pamięci to łatwa połowa. Sztuka polega na decydowaniu, co odczytać z powrotem, ponieważ wszystko, co odczytasz, trafia do promptu i kosztuje tokeny wejściowe. Rozsądna pętla odczytuje garść rzeczy w stałej kolejności. Najpierw ostatnie tury, potem kilka faktów pasujących do pytania, potem stan zadania. Oto ona z oficjalnym klientem Pythona, z Twoją własną funkcją embeddingu i szablonem promptu.
import hotkv

r = hotkv.from_url("hotkv://localhost:6379")
MIN_SIMILARITY = 0.8          # tune on your own data

def start_session(session: str) -> None:
    r.amem_conv_create(session, window=50, ttl=86400)   # create once, before the first append

def build_context(session: str, question: str) -> str:
    r.amem_conv_append(session, "user", question)
    turns = r.amem_conv_window(session, 10)
    facts = r.amem_sem_recall("support-kb", 3, embed(question))
    facts = [f for f in facts if f["similarity"] >= MIN_SIMILARITY]
    ticket = r.amem_work_get(session, "ticket")
    return render(turns, facts, ticket)      # your prompt template

def finish_turn(session: str, agent: str, reply: str) -> None:
    r.amem_conv_append(session, "assistant", reply)
    r.amem_epis_log(agent, "action", "Answered a billing question")
    r.amem_work_set(session, "last_step", "answered")
Próg podobieństwa musisz dostroić sam. Wartość pasująca do jednego modelu embeddingów i jednego zestawu faktów będzie zła dla innego, więc sprawdź recall na pytaniach, dla których znasz odpowiedzi. Odrzucanie słabych dopasowań ma większe znaczenie, niż się wydaje, bo słaby fakt w prompcie jest gorszy niż brak faktu.
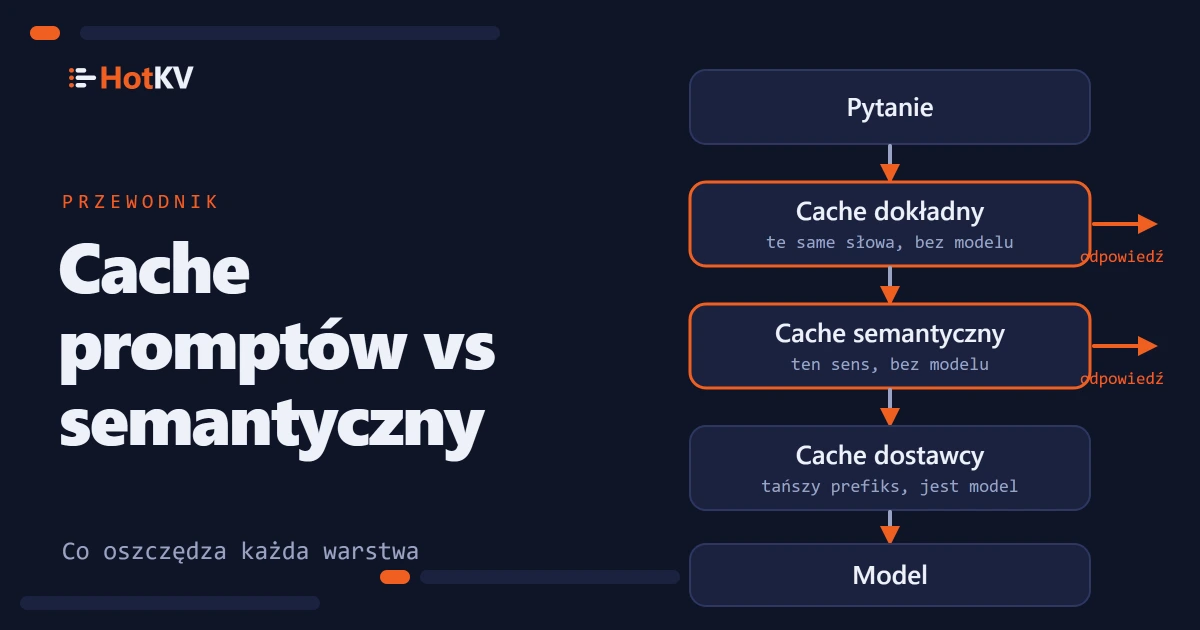
Stabilne części tego promptu, takie jak instrukcje systemowe, to także ta część, którą tańszą czyni cache promptów po stronie dostawcy. Umieść odczytaną pamięć na końcu, po stabilnym tekście, aby jej zmiana nie unieważniała tego cache.
Streszczenia zamiast coraz dłuższych okien
Okno całkowicie porzuca stare tury. To w porządku przy pogaduszkach, a złe przy długim zadaniu, gdzie tura 3 może nadal mieć znaczenie w turze 300. Zwykłą odpowiedzią jest przesuwne streszczenie. Po każdym odcinku rozmowy agent, albo tańszy model, zapisuje, czego się dowiedział, a streszczenie zastępuje w prompcie stare tury.
HotKV przechowuje jedno streszczenie na agenta poleceniami AMEM.SUMMARY.SET, AMEM.SUMMARY.APPEND i AMEM.SUMMARY.GET. SET zastępuje tekst, a APPEND dodaje linię. Każda aktualizacja podnosi numer wersji, więc inny komponent może tanio stwierdzić, że streszczenie się zmieniło i kiedy.
Streszczenie jest stratne, a streszczanie streszczenia traci za każdym razem więcej. Trzymaj dokładne wartości, takie jak identyfikatory, kwoty i daty, poza prozą, w pamięci roboczej lub faktach semantycznych, gdzie przetrwają. Użyj streszczenia do ogólnego kształtu pracy, czyli preferencji, podjętych decyzji i tego, co zostało.
Zasady projektowe i retencja
Pamięć rośnie bez granic, jeśli jej nie zatrzymasz, więc ustaw limity przed pierwszym zapisem.
Zasady, które utrzymują pamięć przydatną
- Ogranicz wszystko. Ustaw
WINDOWna konwersacjach iTTLna sesjach i wartościach roboczych. Dla konwersacji, wartości roboczych i faktów HotKV zapisuje czas wygaśnięcia dla pliku tylko do dopisywania i replik, więc wpis, który wygasł, nie wraca przy odtwarzaniu pliku po restarcie. - Przechowuj fakty, nie transkrypty. Streszczaj, zanim zapiszesz do pamięci semantycznej. Fakt łatwiej przywołać niż stronę dialogu.
- Trzymaj agentów osobno. Używaj osobnego identyfikatora lub przestrzeni nazw na agenta i na tenanta, aby pamięć jednego klienta nigdy nie była przywoływana dla innego.
- Przywołuj kilka, nie wiele. Bierz trzy do pięciu najlepszych dopasowań i odrzucaj słabe według wyniku podobieństwa, zanim trafią do promptu.
- Nie trzymaj sekretów. Pamięć jest odczytywana z powrotem do promptów, więc nigdy nie zapisuj haseł, kluczy ani danych, których nie pokazałbyś modelowi.
Jak długo przechowywać każdy typ
Te czasy życia to nasze sugestie, a nie wartości domyślne. Wybierz własne, zależnie od tego, jak szybko zmieniają się fakty i co wolno Ci przechowywać.
| Typ pamięci | Sugerowany czas życia | Mechanizmy w HotKV |
|---|---|---|
| Konwersacyjna | Sesja lub stały okres, jak doba | WINDOW i TTL w AMEM.CONV.CREATE |
| Robocza | Zadanie, potem wyczyszczona | TTL w AMEM.WORK.SET oraz AMEM.WORK.CLEAR |
| Semantyczna | Dopóki fakt jest prawdziwy | TTL w AMEM.SEM.STORE oraz AMEM.SEM.FORGET |
| Epizodyczna | Tak długo, jak wymaga tego Twój audyt lub wsparcie | AMEM.EPIS.QUERY według zakresu czasu oraz AMEM.EPIS.CLEAR (zdarzenia nie mają czasu życia) |
Retencja to także kwestia prywatności. Jeśli pamięć zawiera cokolwiek o osobie, wybrany czas życia jest częścią tego, co jej obiecujesz, więc zapisz go.
Jak pamięć agentów zawodzi
Większość błędów pamięci jest powolna. Agent działa dobrze przez tydzień, a potem zaczyna być gorszy. Oto awarie, pod które warto projektować.
Typowe awarie
- Nieaktualne fakty. Fakt prawdziwy w marcu jest przywoływany w październiku. Nadaj faktom czas życia lub zapisuj je pod kluczem na encję, aby nowa wartość nadpisywała starą.
- Sprzeczności. Dwa zapisane fakty się nie zgadzają, a agent wybiera jeden losowo. Preferuj jeden fakt na klucz zamiast dopisywania nowych notatek obok starych.
- Nadmierne przywoływanie. Zbyt wiele dopasowań wypełnia prompt luźno powiązanym tekstem. Przywołuj mało i odrzucaj słabe dopasowania.
- Wycieki między użytkownikami. Pamięć jednego klienta jest przywoływana dla innego. Osobne identyfikatory lub przestrzenie nazw dla każdego tenanta, sprawdzane w kodzie przed każdym odczytem.
- Nieograniczony wzrost. Nic nigdy nie wygasa, więc wyszukiwania zwalniają, a koszty rosną. Każdy typ potrzebuje czasu życia. Tam, gdzie HotKV nie ma czasu życia, jak w dzienniku epizodycznym, zaplanuj czyszczenie lub eksport samodzielnie.
- Dryf streszczenia. Streszczenie streszczenia powoli przestaje odpowiadać temu, co się wydarzyło. Zachowaj dziennik zdarzeń jako źródło prawdy i generuj streszczenia na jego podstawie.
Traktuj zapisany tekst jako niezaufany
Ostatni punkt zasługuje na więcej uwagi. Wszystko, co agent zapisuje do pamięci, może później zostać wczytane do promptu. Dotyczy to także tekstu pochodzącego ze strony internetowej, e-maila lub od użytkownika. To pośrednia forma prompt injection, którą OWASP wymienia jako LLM01. Zapisuj źródło przy każdym fakcie. Ufaj mniej pamięci zapisanej z treści z zewnątrz i nigdy nie pozwól, by przywołana notatka nadpisała Twój prompt systemowy.
Co zmierzyliśmy, a czego nie
Opublikowane benchmarki HotKV obejmują przepustowość poleceń, wyszukiwanie wektorowe i oszczędności tokenów dzięki cache odpowiedzi. Pamięć agentów nie ma jeszcze własnego benchmarku. Nie twierdzimy nic o jej opóźnieniu ani o tym, jak bardzo poprawia jakość agenta. Możemy powiedzieć tylko rzeczy architektoniczne. Cztery magazyny działają w tym samym procesie co cache i indeks wektorowy. Wyszukanie w pamięci to jedno wywołanie systemu, który już obsługujesz.
Benchmark oszczędności tokenów i porównanie cache promptów i cache semantycznego pokazują stronę zmierzoną. Przypadek użycia pamięci agentów pokazuje polecenia w pełnym scenariuszu.
Pamięć agentów z Claude Code lub Cursor
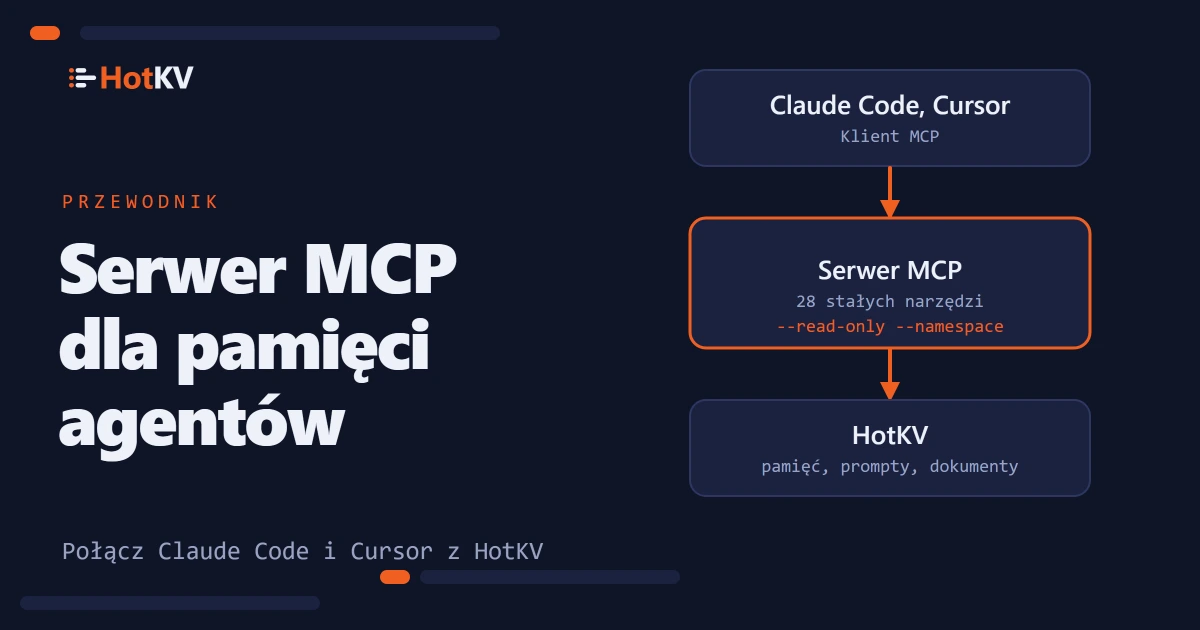
Asystent obsługujący Model Context Protocol może używać części tej pamięci bez własnego kodu. Otwartoźródłowy serwer hotkv-mcp udostępnia jako narzędzia pamięć konwersacji, notatki robocze, dziennik zdarzeń i przesuwne streszczenie. Ma tryb tylko do odczytu i przestrzeń nazw ograniczającą agenta. Nie udostępnia pamięci semantycznej, a jego narzędzia nie mogą ustawić okna ani czasu życia, więc do tego użyj biblioteki klienckiej. Następny artykuł, serwer MCP dla pamięci agentów, pokazuje, jak go podłączyć i co obejmują jego zabezpieczenia.
Najczęściej zadawane pytania
Czym jest pamięć agentów AI?
Pamięć agentów AI to warstwa przechowywania i pobierania, która pozwala agentowi zachowywać informacje między krokami i sesjami. Zwykle łączy okno ostatniej konwersacji, długoterminowe fakty znajdowane według znaczenia, brudnopis bieżącego zadania i dziennik zdarzeń.
Jaka jest różnica między krótko- a długoterminową pamięcią agenta?
Pamięć krótkoterminowa przechowuje to, co dzieje się teraz, jak ostatnie tury i stan zadania, i jest ograniczona oraz tymczasowa. Pamięć długoterminowa przechowuje wiedzę, która powinna przetrwać sesję, jak fakty, preferencje i dawne zdarzenia, i jest przeszukiwana w razie potrzeby.
Czym jest przesuwne streszczenie w pamięci agenta?
Przesuwne streszczenie to krótki, bieżący opis tego, czego agent się dowiedział lub co ustalił do tej pory, aktualizowany w miarę postępu pracy. Zastępuje w prompcie stare tury, aby prompt nie rósł bez końca. HotKV przechowuje jedno na agenta i podnosi numer wersji przy każdej aktualizacji.
Czy potrzebuję bazy wektorowej dla pamięci agenta?
Tylko dla pamięci semantycznej, gdzie fakty są znajdowane według znaczenia. Okna konwersacji, stan roboczy i dzienniki zdarzeń nie potrzebują wektorów. HotKV przechowuje wszystkie cztery w jednym silniku, więc indeks wektorowy i pozostałe magazyny nie są osobnymi systemami.
Jak długo przechowywać pamięć agenta?
To zależy od typu. Pamięć robocza powinna wygasać, gdy zadanie się kończy, konwersacje po sesji lub ustalonym okresie, a dzienniki epizodyczne tak długo, jak wymaga tego Twój audyt. Fakty w pamięci semantycznej należy przeglądać i usuwać, gdy przestają być prawdziwe.
Czy pamięć agenta może zostać zaatakowana?
Tak. Tekst zapisany do pamięci jest później wczytywany do promptów, więc zatruta notatka może sterować agentem. Zapisuj, skąd pochodzi każdy fakt, ufaj mniej treściom z zewnątrz i trzymaj przywołaną pamięć poniżej swojego promptu systemowego pod względem autorytetu.
Czy HotKV przechowuje pamięć agenta w RAM?
HotKV to silnik w pamięci, więc odczyty są obsługiwane z pamięci. Zapisy do czterech magazynów są rejestrowane dla pliku tylko do dopisywania i dla replik, z przekazywanymi czasami wygaśnięcia, zgodnie z dokumentacją produktu.
Kontynuuj rozmowę
Komentarze
Pytania o metodę? Inny wynik na Twoim sprzęcie? Podziel się swoimi wnioskami. Komentarze są sprawdzane, zanim się pojawią.