
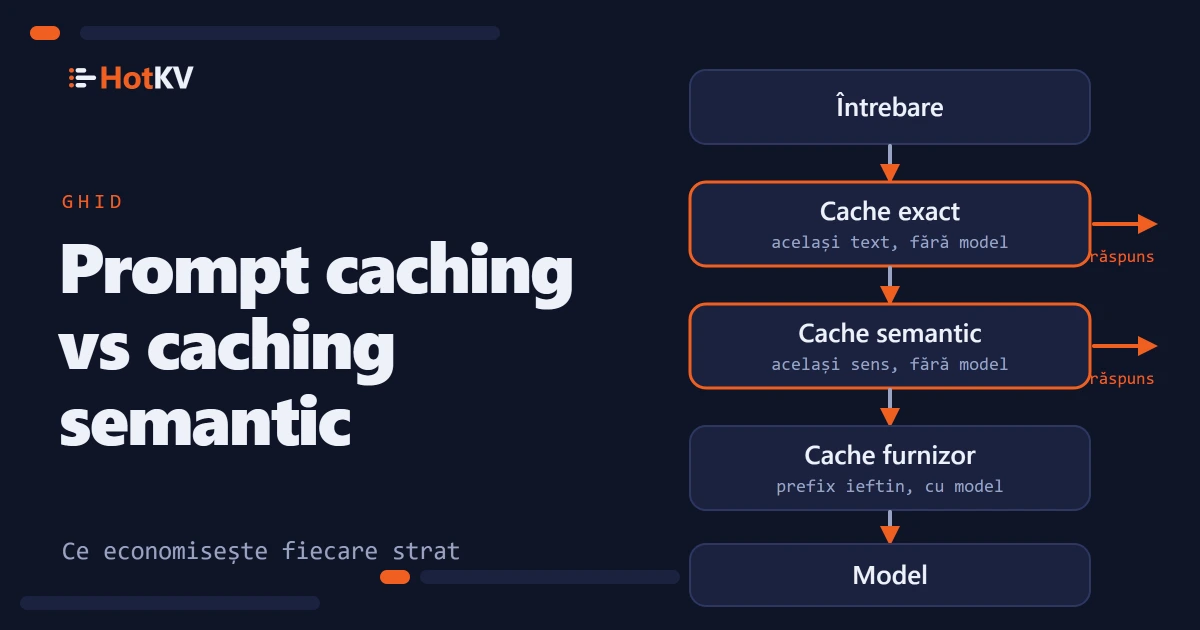
Două lucruri diferite se vând drept caching pentru modelele de limbaj, iar echipele îl cumpără adesea pe unul așteptându-se la celălalt. Prompt caching este o funcție a furnizorului, care face mai ieftină citirea unui prefix repetat de prompt. Caching-ul semantic este un strat pe care îl rulați singuri, care răspunde la o întrebare din memorie, astfel încât modelul nu mai este apelat. Rezolvă jumătăți diferite ale facturii și funcționează cel mai bine împreună.
Pe scurt. Prompt caching reduce prețul începutului repetat al unui prompt, precum un prompt de sistem lung, dar modelul rulează în continuare și plătiți în continuare fiecare token de ieșire. Caching-ul exact și cel semantic elimină apelul cu totul când o întrebare a primit deja răspuns. În benchmark-ul nostru cu 3.000 de cereri, cu prompt caching-ul furnizorului deja activat, adăugarea HotKV în față a redus apelurile către model, tokenii și costul cu aproximativ 70%, pentru că tokenii de ieșire reprezentau în continuare 73% până la 92% din costul de referință.
Cum funcționează prompt caching
Prompt caching trăiește la furnizorul de modele. Marcați începutul stabil al unei cereri, de obicei uneltele și promptul de sistem, iar furnizorul stochează forma lui procesată pentru scurt timp. Următoarea cerere care începe cu textul identic este facturată la un tarif redus pentru acea parte. Descriem aici versiunea Anthropic pentru că aceasta am măsurat-o. Detaliile de mai jos provin din documentația lor despre prompt caching, verificată pe 18 octombrie 2026.
Ce se pune în cache
Un succes cere o potrivire exactă. Fiecare bloc până la cel marcat cu cache_control, inclusiv, trebuie să fie identic, în ordinea unelte, prompt de sistem, apoi mesaje. Schimbați un singur caracter devreme în prompt și tot ce urmează este o ratare. Întrebarea în sine vine ultima, deci nu face niciodată parte din prefixul din cache.
Prompturile sub o lungime minimă nu sunt puse în cache și nu se returnează nicio eroare. Pentru modelele Claude actuale pe care le-am folosit, Fable 5.1, Opus 5.5, Sonnet 5.5 și Haiku 5.5, minimul documentat este de 512 tokeni. Intrările din cache sunt izolate pe organizație și, în API-ul Claude, pe workspace.
Cât costă
Durata de viață implicită este de cinci minute, iar fiecare utilizare a intrării o reîmprospătează fără taxă suplimentară. Este disponibilă și o durată de o oră. Scrierea unei intrări costă de 1,25 ori prețul de bază de intrare pentru cinci minute și de 2 ori pentru o oră. Citirea ei costă de 0,1 ori prețul de bază de intrare la majoritatea modelelor, de 0,05 ori la Opus 5.5 și Sonnet 5.5 și de 0,025 ori la Fable 5.1, conform paginii de prețuri. Acești multiplicatori se schimbă, deci citiți pagina curentă înainte de a face orice calcul.
Ce nu poate elimina prompt caching
Prompt caching reduce prețul citirii prefixului. Nu sare peste model. Fiecare cerere produce în continuare un răspuns nou, îl așteptați în continuare, iar fiecare token de ieșire este facturat la prețul întreg de ieșire.
Benchmark-ul nostru arată cât contează asta. Am trimis 3.000 de întrebări de suport pentru clienți fiecăruia dintre patru modele Claude, cu o politică de 2.200 de tokeni drept prompt de sistem și cu caching-ul furnizorului activat. Între 90% și 93% dintre tokenii numărați erau citiri din cache ale acelei politici. Ieșirea reprezenta doar 6% până la 9% dintre tokeni, dar 73% până la 92% din costul de referință. Prefixul era deja ieftin, deci cheltuiala rămasă stătea în răspunsuri.
Acesta este golul pe care îl umplu celelalte straturi. Metoda completă și rezultatele sunt în benchmark-ul de economisire a tokenilor.
Caching exact și semantic al răspunsurilor
Două straturi răspund la o cerere din memorie. Ele diferă prin felul în care decid că o cerere nouă se potrivește cu una veche.
Caching exact al răspunsurilor
Un cache exact stochează răspunsul final sub o cheie construită din tot ce îl modelează. În mod normal, asta înseamnă modelul, versiunea promptului și întrebarea normalizată. Când aceeași cerere sosește din nou, răspunsul stocat este returnat, iar modelul nu este apelat. Nu există scor de similaritate și nici riscul de a returna un răspuns destinat altei întrebări.
În rularea noastră, cache-ul exact a răspuns la aproximativ 39% dintre cereri. O întrebare repetată s-a întors într-o mediană de aproximativ 0,05 ms. Aceasta a fost măsurată cu un client Python peste loopback, pe aceeași mașină, deci citiți-o ca pe o cifră locală, nu de rețea. Benchmark-ul a folosit simplu GET și SET pentru acest strat. HotKV Enterprise are și un cache de prompturi dedicat, cu potrivire exactă, PCACHE.*, cu limite pe spațiu de nume și urmărirea costurilor.
Caching-ul exact este orb la formulare. „How do I reset my password?” și „I forgot my password” sunt două chei diferite.
Caching semantic
Un cache semantic caută sensul întrebării. Transformă întrebarea într-un embedding, găsește cea mai apropiată întrebare stocată și îi returnează răspunsul dacă similaritatea cosinus depășește un prag. În HotKV, aceasta este SCACHE.*, construit pe același index vectorial ca și căutarea vectorială.
Aproximativ 31% dintre cererile noastre au primit răspuns în acest fel. O parafrază a durat o mediană de aproximativ 130 ms, aproape totul fiind apelul către serviciul de embedding, deci un succes semantic este mult mai rapid decât un apel către model, dar nu instantaneu. Fără stratul semantic, un cache exact singur ar fi avut nevoie de cel mult 1.264 de apeluri către model din 3.000, cu aproximativ 58% mai puține. Stratul semantic a dus economia la aproximativ 70%.
Tot aici stă și riscul. O întrebare similară nu este întotdeauna aceeași întrebare. Am pus un al doilea model Claude să judece fiecare succes semantic față de un răspuns nou. La pragul nostru implicit de 0,81, răspunsurile din cache s-au potrivit întrebării exacte cu 5,8 până la 10,7 puncte procentuale mai rar decât cele noi. La Sonnet 5.5, pragurile de 0,88 și mai mari nu au arătat un astfel de deficit, cu dovezi subțiri. Întrebările scrise să difere printr-un detaliu decisiv s-au potrivit totuși în 62% din cazuri la 0,81 și în 10% la 0,95.
Prompt caching vs caching semantic, una lângă alta
| Prompt caching al furnizorului | Cache exact de răspunsuri | Cache semantic | |
|---|---|---|---|
| Ce elimină | O parte din prețul de intrare | Întregul apel către model | Întregul apel către model |
| Regula de potrivire | Prefix identic | Cerere identică | Sens similar peste un prag |
| Tokeni de ieșire facturați | Da, de fiecare dată | Nu, la un succes | Nu, la un succes |
| Riscul unui răspuns greșit | Niciunul | Niciunul pentru cereri identice | Real, reglat prin prag |
| Unde rulează | La furnizor | În cache-ul dvs. | În cache-ul dvs., plus un apel de embedding |
| Ponderea cererilor în rularea noastră | Mereu activ | Aproximativ 39% | Aproximativ 31% |
Prompt caching al furnizorului și caching-ul răspunsurilor nu sunt alternative. Unul reduce prețul apelurilor pe care tot le faceți, iar celălalt reduce numărul de apeluri pe care le faceți.
Ce face caching-ul cu latența
Să sari peste model schimbă cât de repede sosesc răspunsurile, nu doar cât costă. În rularea noastră, timpul median până la un răspuns complet a scăzut de la 2,7 secunde la 127 ms la Fable 5.1, de la 2,9 secunde la 126 ms la Opus 5.5, de la 1,8 secunde la 128 ms la Sonnet 5.5 și de la 1,4 secunde la 125 ms la Haiku 5.5. Asta înseamnă de 11 până la 23 de ori mai rapid la mediană.
Capătul lent aproape nu s-a mișcat. Aproximativ 30% dintre cereri au ajuns tot la model, iar percentila 99 la Fable 5.1 a fost de aproximativ 6,4 secunde cu HotKV, față de 6,6 secunde fără el. Un cache elimină așteptarea pentru cererile la care răspunde și nu face nimic pentru cele pe care le ratează. Dacă reclamația dvs. este un caz cel mai defavorabil lent, nu unul tipic lent, caching-ul singur nu o va rezolva.
Acestea sunt timpi până la răspunsul complet, pentru că apelurile nu au fost în streaming. Un răspuns în streaming își arată primele cuvinte mai devreme. Diferența dintr-o fereastră de chat este mai mică decât diferența din aceste cifre.
Alegerea unui strat pentru traficul dvs.
Stratul potrivit depinde de cum se repetă cererile dvs., iar asta puteți măsura înainte să construiți ceva.
Potriviți stratul cu traficul
Potriviți stratul cu felul în care se repetă cererile dvs.
- Un prompt de sistem sau o listă de unelte lungi și stabile: folosiți prompt caching al furnizorului. Costă puțin de pornit și nu schimbă niciun răspuns.
- Aceeași întrebare, cu aceleași cuvinte, precum un buton, un șablon sau o reîncercare: folosiți un cache exact de răspunsuri. Este sigur și rapid.
- Trafic de suport, căutare și FAQ în care oamenii întreabă același lucru cu alte cuvinte: adăugați un cache semantic, setați pragul sus și verificați calitatea răspunsurilor pe propriile întrebări înainte să vă bazați pe el.
- Răspunsuri care depind de utilizator, de ceas sau de date live: nu puneți niciunul în cache sau construiți cheia din faptele care schimbă răspunsul.
Economiile urmează repetiția. Când am făcut fiecare intenție la fel de probabilă în loc de înclinată, costul a scăzut cu 56% la cele două modele pe care le-am rulat din nou, iar cu 3.000 de întrebări toate diferite a scăzut cu 38%. O sarcină fără întrebări repetate sau similare nu economisește nimic.
Măsurați mai întâi propria repetiție
Înainte să construiți ceva, aflați cât din traficul dvs. se repetă. Cifra decide dacă merită un cache exact. Durează zece minute cu întrebările pe care le înregistrați deja. Normalizați fiecare întrebare așa cum o va face cheia din cache, numărați-le pe cele distincte și vedeți cât din trafic a fost o repetare.
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_share este fracția de cereri la care ar fi răspuns un cache exact, odată ce a văzut fiecare întrebare o primă dată. Setul nostru de test a avut 1.264 de întrebări distincte la 3.000 de cereri, deci cifra a fost de aproximativ 58%. Dacă a dvs. iese aproape de 5%, un cache exact va face puțin, iar doar un strat semantic poate ajuta.
Se aplică două precauții. Un cache începe gol, deci primele cereri ajung mereu la model. În rularea noastră, aproximativ 52% dintre primele o mie de cereri au fost servite din cache și aproximativ 81% dintre ultimele o mie. Iar un jurnal al traficului din luna trecută vă spune despre luna trecută. Dacă sunteți pe cale să lansați o funcție care schimbă ce întreabă oamenii, tratați cifra ca pe un ghid aproximativ.
Îmbinarea straturilor
O cerere ar trebui să treacă prin straturi de la cel mai ieftin și mai sigur la cel mai scump și ar trebui să puteți vedea ce a economisit fiecare.
Ordinea căutărilor
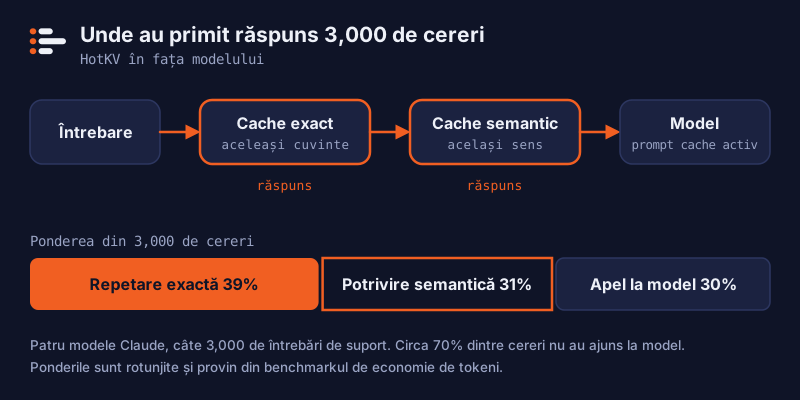
Ordinea contează. Verificați mai întâi stratul cel mai ieftin și mai sigur și apelați modelul doar când toate ratează. Această schiță presupune un client în stil redis-py cu decode_responses=True, două spații de nume create în prealabil și propriile dvs. funcții embed și llm.
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # same words

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # same meaning

    reply = llm.complete(question)                   # provider prompt caching applies here
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
Creați spațiile de nume o singură dată cu PCACHE.CREATE answers_exact și SCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90, folosind dimensiunea modelului dvs. de embedding. Setul de comenzi IA vine cu instanțele HotKV Cloud Performance și Scale, iar pagina IA listează ce face fiecare motor. Pagina de prețuri arată ce plan include ce.
Ținerea scorului în producție
Un cache pe care nu îl puteți vedea este un cache în care nu vă puteți baza. HotKV păstrează numărul de succese și de ratări pe spațiu de nume. Dacă stocați utilizarea de tokeni a apelului inițial împreună cu fiecare intrare, poate atribui și tokenii și costul pe care le-a evitat fiecare succes ulterior. Răspunsurile PCACHE.STATS și SCACHE.STATS conțin atunci câmpuri precum usage_saved_requests, usage_saved_input_tokens și usage_saved_cost_usd.
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
Înlocuiți <model> cu id-ul modelului dvs. INPUT numără tokenii de prompt necachuiți, iar CACHEREAD tokenii pe care furnizorul i-a servit din propriul cache, deci cele două nu se suprapun. Modelul trebuie să fie în tabelul de prețuri al HotKV ca să aibă sens câmpul de cost. LLMSTATS.PRICE LIST arată ce modele sunt cunoscute, iar LLMSTATS.PRICE SET o adaugă pe a dvs. Un model fără preț își are totuși tokenii numărați, dar costul lui este înregistrat ca zero, iar un contor separat arată că cererile au rămas neprețuite.
Cache-urile reduc cheltuielile, iar un buget plafonează ce rămâne. LLMBUDGET.SET definește o limită de tokeni și de dolari pe o fereastră de timp. LLMBUDGET.CONSUME este verificat înainte de apelul către model, deci un agent scăpat de sub control este oprit înainte să cheltuiască banii, nu după. LLMSTATS.RECORD păstrează totaluri pe tenant care înțeleg tokenii de citire și de scriere în cache ai furnizorului. Toate trei folosesc un singur tabel de prețuri când transmiteți numele modelului, deci o economie, un buget și o cifră din dashboard nu se pot contrazice.
Greșeli care fac un cache să returneze răspunsuri greșite
Majoritatea succeselor proaste în cache vin dintr-o cheie căreia îi lipsește ceva. Puneți modelul, versiunea promptului și orice versiune de unealtă sau de politică în cheia exactă, ca o schimbare de prompt să nu poată servi răspunsuri scrise pentru cel vechi.
Dați intrărilor o durată de viață potrivită cu cât de repede se schimbă faptele dvs. Țineți tenanții separați prin spații de nume diferite, ca răspunsul unui client să nu fie oferit niciodată altuia. Nu puneți niciodată în cache un răspuns care conține date personale, decât dacă cheia include a cui sunt datele.
În sfârșit, măsurați pe propriul trafic. Cifrele noastre provin dintr-un singur set de date public cu întrebări bancare scurte, o politică fictivă și o rulare pe condiție și nu sunt o promisiune pentru sarcina dvs.
Întrebări frecvente
Ce este prompt caching?
Prompt caching este o funcție a furnizorului de modele, care stochează pentru scurt timp începutul procesat al unui prompt. O cerere ulterioară care începe cu exact același text este facturată la un tarif mai mic pentru acea parte. Modelul rulează în continuare și produce un răspuns nou, deci plătiți în continuare tokenii de ieșire.
Este prompt caching același lucru cu caching-ul semantic?
Nu. Prompt caching reutilizează un prefix repetat de prompt și apelează în continuare modelul. Caching-ul semantic returnează un răspuns stocat la o întrebare cu sens similar și sare peste apelul către model. Ele se ocupă de costuri diferite și pot fi folosite împreună.
Reduce prompt caching costurile tokenilor de ieșire?
Nu. Reduce doar prețul citirii prefixului din cache. În benchmark-ul nostru, ieșirea reprezenta 6% până la 9% dintre tokeni, dar 73% până la 92% din costul de referință cu prompt caching deja activat, motiv pentru care punerea în cache a răspunsurilor întregi a economisit mult mai mult.
Cât durează cache-ul de prompturi al Anthropic?
Implicit, cinci minute, reîmprospătate de fiecare dată când intrarea este folosită. Este disponibilă o opțiune de o oră, la un preț mai mare de scriere. Verificați documentația curentă, pentru că limitele și prețurile se schimbă.
Pot folosi împreună prompt caching și caching-ul semantic?
Da, iar benchmark-ul nostru a făcut exact asta. Prompt caching al furnizorului a rămas activ în ambele rulări, iar straturile semantic și exact au stat în fața modelului. Succesele din cache sar peste apel, iar ratările tot beneficiază de prefixul redus ca preț.
Ce prag de similaritate ar trebui să folosească un cache semantic?
Nu există o valoare universală. Noi am ales 0,81 pe un set separat de antrenare, iar la Sonnet 5.5 răspunsurile din cache nu au arătat un deficit de calitate față de cele noi de la 0,88 în sus, cu dovezi subțiri. Începeți sus, judecați răspunsurile din cache față de cele noi pe propriile întrebări și coborâți pragul doar dacă se menține calitatea.
Continuați conversația
Comentarii
Aveți întrebări despre metodă? Ați obținut un alt rezultat pe hardware-ul dvs.? Spuneți-ne ce ați aflat. Comentariile sunt verificate înainte de a apărea.