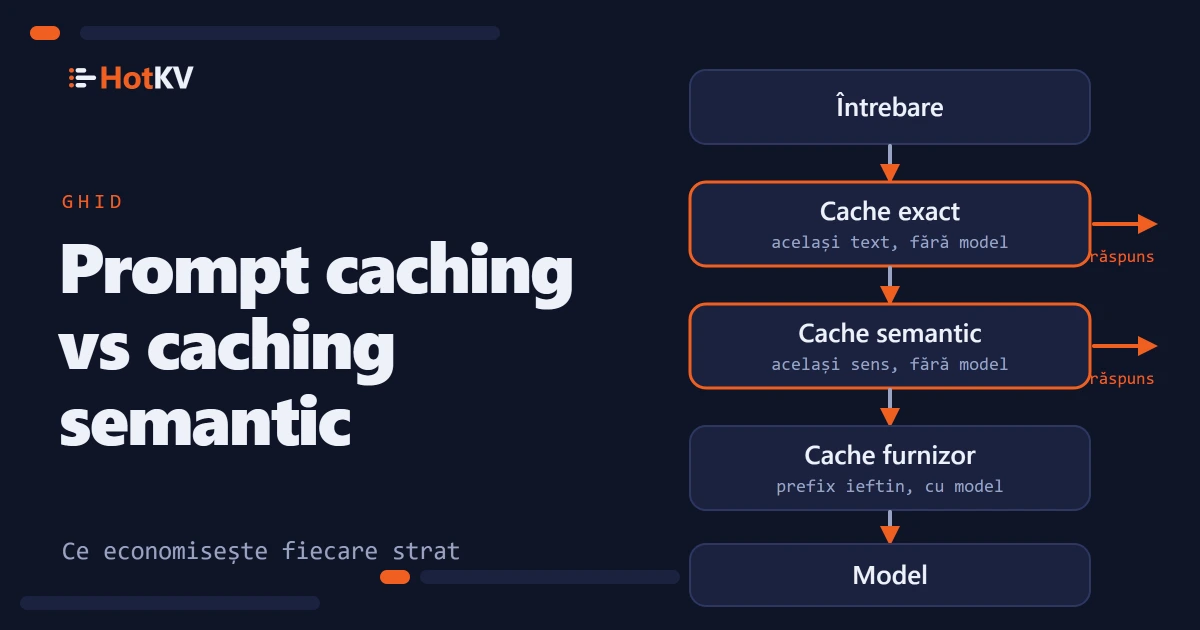
Prompt caching vs caching semantic: ce economisește fiecare
Prompt caching face mai ieftin un prefix repetat. Caching-ul semantic elimină apelul către model. Cum funcționează fiecare, ce am măsurat și pe care să-l folosiți când.
Etichetă
Cache de prompturi la furnizor și cache de răspunsuri pentru aplicații LLM, cu ce economisește fiecare la tokeni și costuri și limita de la care nu mai ajută.
2 articole în Caching de prompturi
Prompt caching face mai ieftin un prefix repetat. Caching-ul semantic elimină apelul către model. Cum funcționează fiecare, ce am măsurat și pe care să-l folosiți când.
Four Claude models, 3,000 support requests each: HotKV caching cut model calls, tokens and API cost by about 70%. Results and answer-quality trade-offs.
Urmați-vă curiozitatea