
Memoria unui agent IA este ceea ce îi permite să ducă ceva de la un pas la următorul sau de la o sesiune la alta. Un model de limbaj singur nu își amintește nimic între două apeluri. Tot ce pare să își amintească a fost pus la loc în prompt de codul dvs. Felul în care stocați și regăsiți acest material stabilește ce poate reține agentul, cât de repede și la ce cost pe rundă.
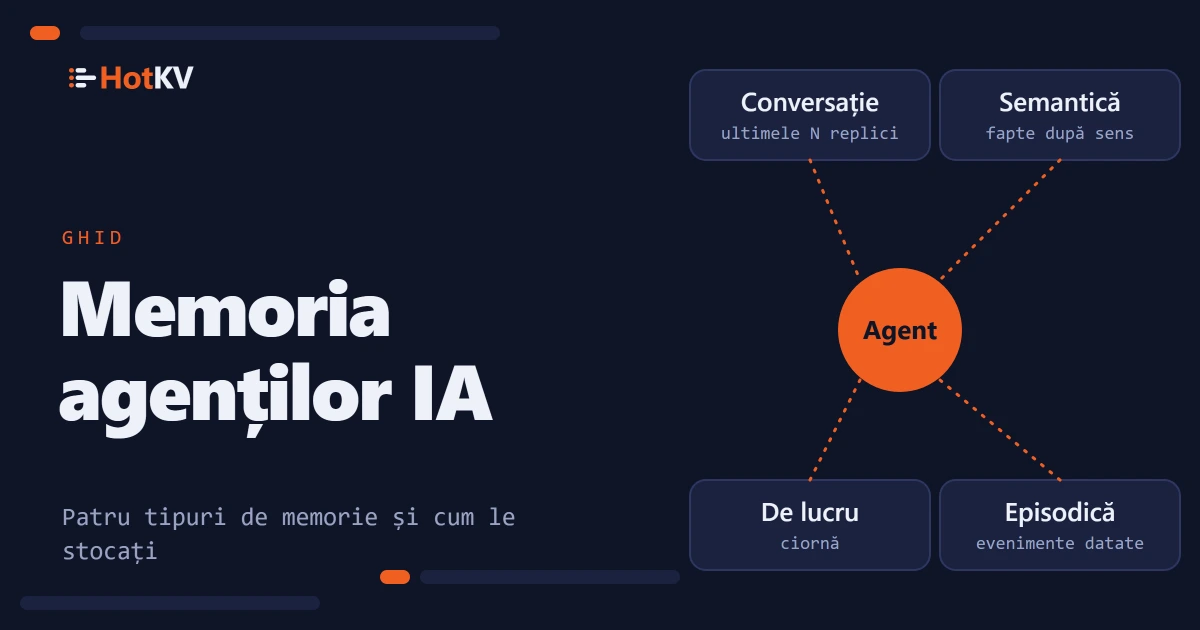
Pe scurt. Agenții au nevoie de patru tipuri de memorie: o fereastră scurtă de conversație, fapte pe termen lung găsite după sens, o ciornă pentru sarcina în curs și un jurnal al celor întâmplate. Fiecare are altă formă, altă durată de viață și altă căutare, deci un singur tabel de memorie nu se potrivește bine niciuneia. HotKV le stochează pe toate patru într-un singur motor în memorie, cu comenzile
AMEM.*. Am măsurat caching-ul și căutarea vectorială din HotKV, nu memoria agenților, așa că acest articol explică designul și nu pretinde nicio accelerare.
De ce o fereastră de context nu este memorie
O fereastră de context este textul pe care îl trimiteți cu fiecare cerere. Are o limită de dimensiune, plătiți tokeni de intrare pentru tot ce conține la fiecare rundă și dispare când se încheie sesiunea. În plus, nu poate fi căutată. Dacă un agent are nevoie de un singur fapt de acum trei săptămâni, lipirea întregului istoric nu este un răspuns.
Memoria este stratul care decide ce intră în fereastră în continuare. Păstrează rundele recente și găsește puținele fapte mai vechi care contează. Reține starea sarcinii curente și înregistrează ce a făcut agentul. Cercetătorii descriu agenții în termeni asemănători. Framework-ul CoALA de Sumers, Yao, Narasimhan și Griffiths separă memoria de lucru de memoria episodică, semantică și procedurală pe termen lung.
Cele patru tipuri de memorie pentru agenți IA
Cele patru stocuri HotKV acoperă în mare același teren, adaptat la ce are de construit o aplicație. Memoria procedurală, adică savoir-faire-ul din codul și prompturile agentului, stă de obicei în depozitul dvs. de cod sau într-un registru de prompturi și nu este un stoc de sine stătător.
Memoria conversațională
Este transcrierea pe termen scurt a unei sesiuni. Mesajele au un rol (system, user, assistant sau tool). Stau într-o fereastră glisantă delimitată, deci cele mai vechi replici cad odată ce se atinge limita. Răspunde la o singură întrebare. Ce s-a spus recent? În HotKV acestea sunt AMEM.CONV.CREATE, AMEM.CONV.APPEND și AMEM.CONV.WINDOW.
Memoria semantică
Memoria semantică este cunoaștere pe termen lung, stocată ca fapte cu un vector de embedding. Agentul le regăsește după sens, nu după cheie. Se sprijină pe un index vectorial HNSW, de același fel cu cel care stă la baza căutării vectoriale. AMEM.SEM.STORE salvează un fapt, iar AMEM.SEM.RECALL returnează cele mai bune potriviri, cu un scor de similaritate. Aici își au locul documentele, preferințele utilizatorilor și corecțiile învățate.
Memoria de lucru
Memoria de lucru este ciorna pentru o sarcină în curs, un set simplu de chei și valori delimitat la o sesiune. Reține pasul curent, tichetul tratat sau un rezultat parțial. Ar trebui să dispară când se termină sarcina. AMEM.WORK.SET acceptă un timp de viață (TTL) tocmai din acest motiv.
Memoria episodică
Memoria episodică este un jurnal append-only de evenimente cu marcaj de timp, precum o acțiune întreprinsă, o observație făcută sau o decizie luată. Îi permite unui agent, sau unei persoane care îl verifică, să întrebe ce s-a întâmplat și când. AMEM.EPIS.LOG scrie un eveniment, iar AMEM.EPIS.QUERY le citește înapoi după tip și interval de timp.
Memoria agenților IA în practică
Două lucruri contează în practică. Cum scrieți în memorie și ce citiți înapoi la fiecare rundă.
Stocarea memoriei cu comenzi
Iată un agent de suport care tratează o conversație. Textul fictiv al politicii și vectorii cu trei numere sunt doar pentru ilustrare. Un model de embedding real produce vectori de 768 sau 1.536 de numere, iar spațiul de nume îl creați cu acea dimensiune.
AMEM.CONV.CREATE session-42 WINDOW 50 TTL 86400
AMEM.CONV.APPEND session-42 user "My invoice shows the wrong VAT number."
AMEM.WORK.SET session-42 ticket "INV-1932" TTL 3600
AMEM.EPIS.LOG agent-support action "Looked up invoice INV-1932"

AMEM.SEM.CREATE support-kb 3
AMEM.SEM.STORE support-kb vat-policy "VAT details can be corrected within 30 days." 0.1 0.2 0.3
AMEM.SEM.RECALL support-kb 3 0.1 0.2 0.3
AMEM.CONV.WINDOW session-42 10
La fiecare rundă, agentul citește fereastra recentă și regăsește puținele fapte care se potrivesc întrebării. Își verifică nota de lucru și construiește promptul din aceste piese. După ce acționează, înregistrează evenimentul. Nimic din această buclă nu are nevoie de întregul istoric.
Citirea memoriei la fiecare rundă
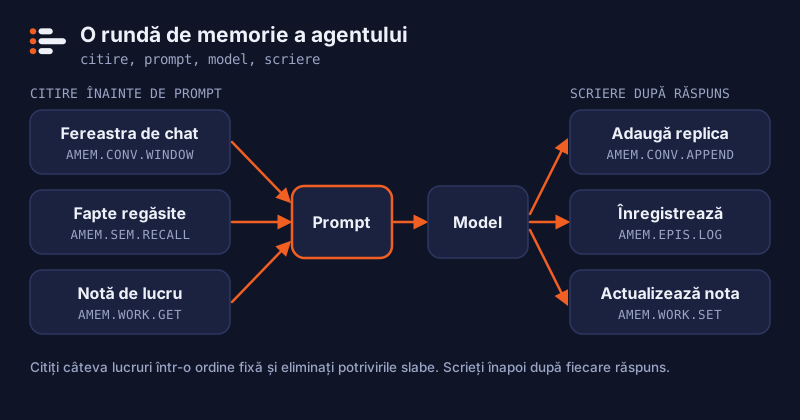
Stocarea memoriei este jumătatea ușoară. Arta stă în a decide ce citiți înapoi, pentru că tot ce citiți intră în prompt și costă tokeni de intrare. O buclă rezonabilă citește câteva lucruri într-o ordine fixă. Mai întâi replicile recente, apoi puținele fapte care se potrivesc întrebării, apoi starea sarcinii. Iată-o cu clientul oficial Python, cu propria dvs. funcție de embedding și propriul șablon de prompt.
import hotkv

r = hotkv.from_url("hotkv://localhost:6379")
MIN_SIMILARITY = 0.8          # tune on your own data

def start_session(session: str) -> None:
    r.amem_conv_create(session, window=50, ttl=86400)   # create once, before the first append

def build_context(session: str, question: str) -> str:
    r.amem_conv_append(session, "user", question)
    turns = r.amem_conv_window(session, 10)
    facts = r.amem_sem_recall("support-kb", 3, embed(question))
    facts = [f for f in facts if f["similarity"] >= MIN_SIMILARITY]
    ticket = r.amem_work_get(session, "ticket")
    return render(turns, facts, ticket)      # your prompt template

def finish_turn(session: str, agent: str, reply: str) -> None:
    r.amem_conv_append(session, "assistant", reply)
    r.amem_epis_log(agent, "action", "Answered a billing question")
    r.amem_work_set(session, "last_step", "answered")
Pragul de similaritate rămâne la latitudinea dvs. O valoare care se potrivește unui model de embedding și unui set de fapte va fi greșită pentru altul, așa că verificați regăsirea pe întrebări la care știți răspunsurile. Eliminarea potrivirilor slabe contează mai mult decât pare, pentru că un fapt slab în prompt este mai rău decât niciun fapt.
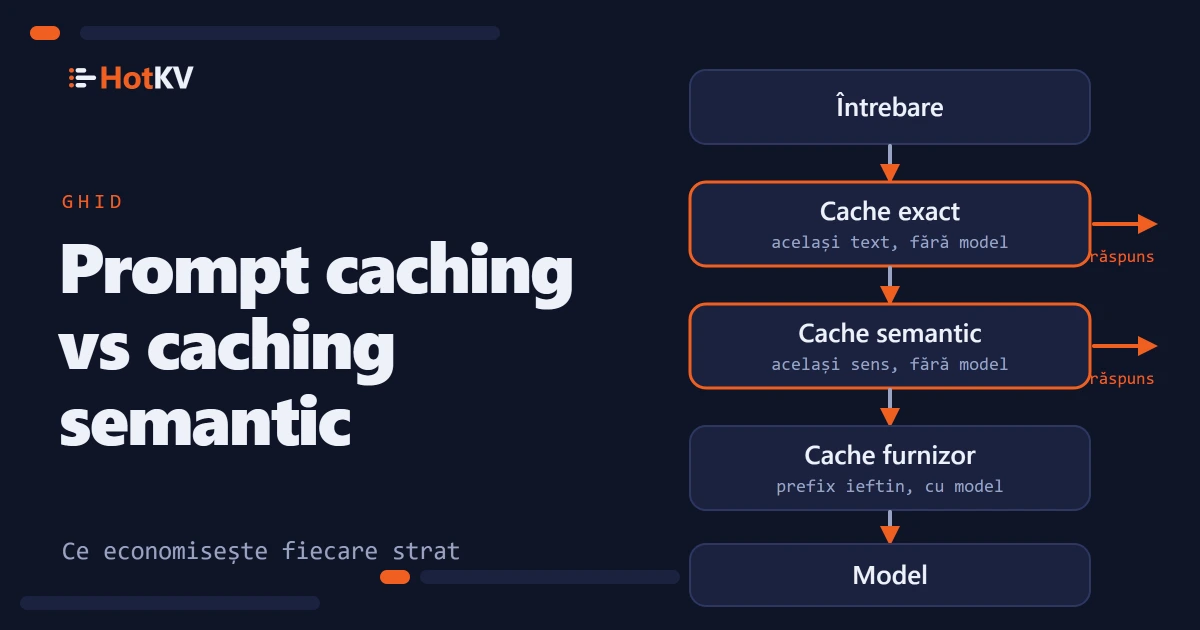
Părțile stabile ale acestui prompt, precum instrucțiunile de sistem, sunt și partea pe care caching-ul de prompturi al furnizorului o face mai ieftină. Puneți memoria citită la sfârșit, după textul stabil, ca modificarea ei să nu invalideze acel cache.
Rezumate în loc de ferestre tot mai lungi
O fereastră elimină complet replicile vechi. Asta e în regulă pentru conversații banale și rău pentru o sarcină lungă, în care replica 3 poate conta încă la replica 300. Un rezumat continuu este răspunsul obișnuit. După fiecare tronson de conversație, agentul sau un model mai ieftin notează ce s-a aflat, iar rezumatul înlocuiește replicile vechi în prompt.
HotKV păstrează un rezumat per agent cu AMEM.SUMMARY.SET, AMEM.SUMMARY.APPEND și AMEM.SUMMARY.GET. SET înlocuiește textul, iar APPEND adaugă o linie. Fiecare actualizare mărește un număr de versiune, deci o altă componentă poate vedea ieftin că rezumatul s-a schimbat și când.
Un rezumat pierde informație, iar rezumarea unui rezumat pierde tot mai mult de fiecare dată. Țineți valorile exacte, precum identificatorii, sumele și datele, în afara textului și în memoria de lucru sau în faptele semantice, unde supraviețuiesc. Folosiți rezumatul pentru forma muncii, precum preferințele, deciziile luate și ce a mai rămas.
Reguli de design și retenție
Memoria crește fără limită dacă nu o opriți, așa că stabiliți limitele înainte de prima scriere.
Reguli care mențin memoria utilă
- Limitați totul. Setați un
WINDOWpe conversații și unTTLpe sesiuni și pe valorile de lucru. Pentru conversații, valori de lucru și fapte, HotKV înregistrează momentul expirării pentru fișierul append-only și pentru replici, deci o intrare expirată nu revine când fișierul este reluat după o repornire. - Stocați fapte, nu transcrieri. Rezumați înainte de a scrie în memoria semantică. Un fapt este mai ușor de regăsit decât o pagină de dialog.
- Țineți agenții separați. Folosiți un identificator sau un spațiu de nume separat pe agent și pe tenant, ca memoria unui client să nu fie niciodată regăsită pentru altul.
- Regăsiți puține, nu multe. Luați primele trei până la cinci potriviri și eliminați-le pe cele slabe după scorul de similaritate înainte să intre în prompt.
- Țineți secretele departe. Memoria este citită înapoi în prompturi, deci nu stocați niciodată parole, chei sau date pe care nu le-ați arăta modelului.
Cât timp păstrați fiecare tip
Aceste durate sunt sugestiile noastre, nu valori implicite. Alegeți-le pe ale dvs. după cât de repede se schimbă faptele de dedesubt și ce aveți voie să păstrați.
| Tip de memorie | Durată sugerată | Controale în HotKV |
|---|---|---|
| Conversațională | Sesiunea sau o perioadă fixă, precum o zi | WINDOW și TTL la AMEM.CONV.CREATE |
| De lucru | Sarcina, apoi ștearsă | TTL la AMEM.WORK.SET și AMEM.WORK.CLEAR |
| Semantică | Până când faptul încetează să mai fie adevărat | TTL la AMEM.SEM.STORE și AMEM.SEM.FORGET |
| Episodică | Cât cer nevoile dvs. de audit sau de suport | AMEM.EPIS.QUERY după interval de timp și AMEM.EPIS.CLEAR (evenimentele nu au TTL) |
Retenția este și o chestiune de confidențialitate. Dacă memoria conține ceva despre o persoană, durata pe care o alegeți face parte din ce îi promiteți, așa că notați-o.
Cum ajunge memoria agentului să dea greș
Cele mai multe bug-uri de memorie sunt lente. Agentul funcționează bine o săptămână, apoi începe să se înrăutățească. Acestea sunt eșecurile împotriva cărora trebuie să proiectați.
Eșecuri frecvente
- Fapte învechite. Un fapt care era adevărat în martie este regăsit în octombrie. Dați faptelor un timp de viață sau stocați-le sub o cheie pe entitate, ca valoarea nouă să o suprascrie pe cea veche.
- Contradicții. Două fapte stocate se contrazic, iar agentul alege unul la întâmplare. Preferați un fapt per cheie în locul adăugării de note noi lângă cele vechi.
- Regăsire excesivă. Prea multe potriviri umplu promptul cu text vag legat de subiect. Regăsiți puține și eliminați potrivirile slabe.
- Scurgeri între utilizatori. Memoria unui client este regăsită pentru altul. Identificatori sau spații de nume separate pentru fiecare tenant, verificate în cod înainte de fiecare citire.
- Creștere nelimitată. Nimic nu expiră vreodată, deci căutările încetinesc, iar costurile cresc pe nesimțite. Fiecare tip are nevoie de o durată de viață. Acolo unde HotKV nu are TTL, ca pentru jurnalul episodic, programați singuri o ștergere sau un export.
- Deriva rezumatului. Un rezumat al unui rezumat încetează încet să mai corespundă cu ce s-a întâmplat. Păstrați jurnalul de evenimente ca sursă de adevăr și regenerați rezumatele din el.
Tratați textul stocat ca nesigur
Ultimul punct merită mai multă atenție. Orice scrie un agent în memorie poate fi citit mai târziu într-un prompt. Asta include text venit de pe o pagină web, dintr-un e-mail sau de la un utilizator. Aceasta este forma indirectă de prompt injection pe care OWASP o listează ca LLM01. Stocați sursa fiecărui fapt. Aveți mai puțină încredere în memoria scrisă din conținut din exterior și nu lăsați niciodată o notă regăsită să treacă peste promptul dvs. de sistem.
Ce am măsurat și ce nu
Benchmark-urile publicate ale HotKV acoperă debitul comenzilor, căutarea vectorială și economiile de tokeni obținute prin caching-ul răspunsurilor. Memoria agenților nu are încă un benchmark propriu. Nu facem nicio afirmație despre latența ei sau despre cât îmbunătățește calitatea agentului. Ce putem spune ține de arhitectură. Cele patru stocuri rulează în același proces cu cache-ul și cu indexul vectorial. O căutare în memorie este un singur apel către un sistem pe care îl operați deja.
Benchmark-ul de economisire a tokenilor și comparația dintre caching-ul de prompturi și cel semantic arată partea măsurată. Cazul de utilizare al memoriei agenților arată comenzile într-un scenariu complet.
Memoria agenților din Claude Code sau Cursor
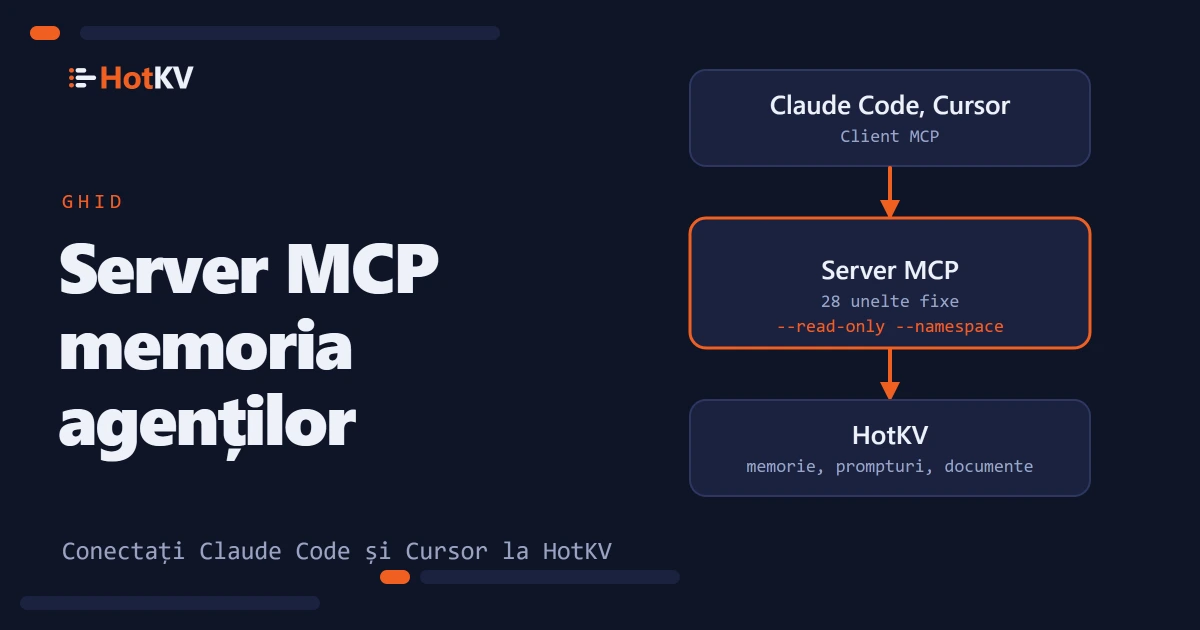
Un asistent care acceptă Model Context Protocol poate folosi o parte din această memorie fără cod personalizat. Serverul open source hotkv-mcp expune memoria conversațională, notele de lucru, un jurnal de evenimente și un rezumat continuu ca unelte. Are un mod numai-citire și un spațiu de nume care limitează agentul. Nu expune memoria semantică, iar uneltele lui nu pot seta o fereastră sau un TTL, așa că folosiți biblioteca client pentru acestea. Articolul următor, un server MCP pentru memoria agenților, arată cum îl conectați și ce acoperă măsurile lui de protecție.
Întrebări frecvente
Ce este memoria agenților IA?
Memoria agenților IA este stratul de stocare și regăsire care permite unui agent să păstreze informații între pași și între sesiuni. De obicei combină o fereastră recentă de conversație, fapte pe termen lung găsite după sens, o ciornă pentru sarcina curentă și un jurnal de evenimente.
Care este diferența dintre memoria pe termen scurt și cea pe termen lung a agenților?
Memoria pe termen scurt reține ce se întâmplă acum, precum replicile recente și starea sarcinii, și este delimitată și temporară. Memoria pe termen lung reține cunoștințe care ar trebui să depășească o sesiune, precum faptele, preferințele și evenimentele trecute, și este căutată la nevoie.
Ce este un rezumat continuu în memoria agenților?
Un rezumat continuu este o scurtă descriere permanent actualizată a ce a aflat sau a decis un agent până acum, pusă la punct pe măsură ce munca avansează. Înlocuiește replicile vechi din prompt, ca promptul să nu tot crească. HotKV stochează unul per agent și mărește un număr de versiune la fiecare actualizare.
Am nevoie de o bază de date vectorială pentru memoria agenților?
Doar pentru memoria semantică, unde faptele sunt găsite după sens. Ferestrele de conversație, starea de lucru și jurnalele de evenimente nu au nevoie de vectori. HotKV le ține pe toate patru într-un singur motor, deci indexul vectorial și celelalte stocuri nu sunt sisteme separate.
Cât timp ar trebui păstrată memoria agenților?
Depinde de tip. Memoria de lucru ar trebui să expire când se termină sarcina, conversațiile după sesiune sau după o perioadă stabilită, iar jurnalele episodice cât cer nevoile dvs. de audit. Faptele din memoria semantică ar trebui revizuite și eliminate când încetează să mai fie adevărate.
Poate fi atacată memoria agenților?
Da. Textul scris în memorie este citit ulterior în prompturi, deci o notă otrăvită poate dirija agentul. Notați de unde vine fiecare fapt, aveți mai puțină încredere în conținutul din exterior și păstrați memoria regăsită sub promptul de sistem ca autoritate.
Stochează HotKV memoria agenților în RAM?
HotKV este un motor în memorie, deci citirile sunt servite din memorie. Scrierile în cele patru stocuri sunt înregistrate pentru fișierul append-only și pentru replici, cu momentele de expirare transmise mai departe, conform documentației produsului.
Continuați conversația
Comentarii
Aveți întrebări despre metodă? Ați obținut un alt rezultat pe hardware-ul dvs.? Spuneți-ne ce ați aflat. Comentariile sunt verificate înainte de a apărea.