このRedisレイテンシベンチマークは、固定のリクエストレートでHotKV、Redis、Valkey、Dragonflyが応答するまでにかかる時間を測ります。これまでのベンチマークはスループットを測っていましたが、読者の方から、スループットがすべてではないという指摘をいただきました。そこで負荷を一定に保ち、段階的に上げながら、各段階で中央値(p50)と99パーセンタイル(p99)を記録しました。pub/subの配信時間も測っています。
要点。 AWS上のこのRedisレイテンシベンチマークでは、HotKVとDragonflyはどちらも毎秒160万GETを維持しました。I/Oスレッド8のRedisは約80万、I/Oスレッド8のValkeyは約40万、シングルスレッドのRedisとValkeyは約20万でした。毎秒20万から160万リクエストの範囲で、HotKVのp99は0.59〜0.76 msに収まり、Dragonflyは0.71〜1.48 msでした。負荷が軽いときはマルチスレッドの各製品がp99で並び、pub/subの配信も差はありませんでした。
固定レートでRedisレイテンシベンチマークを行った理由
スループットのテストはサーバーを限界まで押して、どれだけ処理したかを報告します。これでは、1件のリクエストがどれだけ待たされるかはほとんどわかりません。レイテンシのテストは、クライアントが毎秒送るリクエスト数を固定し、それぞれの所要時間を測ります。こうすればサーバーは他の製品と同じ負荷になり、時間を比較できます。
このテストには落とし穴があります。memtier_benchmarkはクローズドループのツールで、クライアントは応答を受け取ってから次のリクエストを送ります。サーバーが追いつかないと、クライアントは単に送る数を減らし、送れたリクエストのレイテンシは実際より良く見えます。そこで、達成したレートが要求したレートの97パーセント以上のときだけ、その段階を「維持できた」と数えます。この条件を満たさない段階は表で「NS」(維持できず)と表示し、レイテンシは載せていません。
テストの内容
マシン
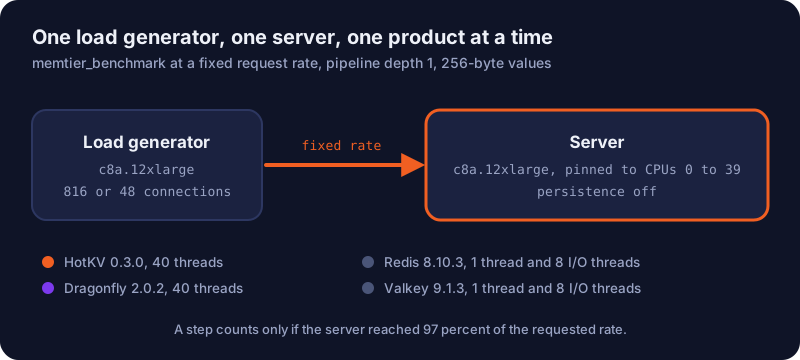
- サーバーと負荷生成マシン。 eu-south-2aのAWSクラスタープレイスメントグループにある
c8a.12xlargeインスタンス(AMD EPYC 9R45、48コア、SMTなし、96 GiB、22.5 Gbit/sのネットワーク)で、OSはUbuntu 24.04です。1台が負荷生成を、もう1台がサーバーを担当しました。 - 製品は1つずつ。 各製品はサーバー上で単独で動かしたため、動作が重なることも、ネットワークを共有することもありませんでした。サーバープロセスはすべてCPU 0〜39に固定し、永続化とプロテクテッドモードは無効にしています。
製品
- HotKV 0.3.0、40スレッド。
- Dragonfly 2.0.2、40プロアクタースレッド。
- Redis 8.10.3とValkey 9.1.3。それぞれ、既定のシングルスレッド設定と
--io-threads 8の2通りで実行しました。
各実行の起動コマンドとCONFIG GETの出力は、結果と一緒に保存しています。
負荷と手順
データセットは、256バイトの値を持つ1,000,000個のキーで、パイプライン深度は1です。つまり各リクエストは自分の応答を待ちます。負荷はGETのみと、書き込み1に対して読み取り10の混合の2種類です。各段階は20秒を2回実行し、2回の平均を報告します。memtier_benchmarkは接続ごとのレート制限を使い、HDRヒストグラムを記録しました。接続数は2通り試しています。
- 816接続(34接続のスレッドを24本)。レートは毎秒20,000から240万リクエストまで。
- 48接続(12接続のスレッドを4本)。レートは毎秒300,000リクエストまで。それ以上は、各接続が応答を受け取った速さでしか送れないため、48接続ではレートに届きません。
結果
まず接続数ごとのGETの表、続いてpub/subです。
816接続
各セルはGETのp50 / p99(ミリ秒)です。「NS」は維持できなかったことを示し、実際に達したレートを括弧内に示します。ハイフンは、その製品の測定がすでに止まっていたことを表します。
| リクエスト/秒 | HotKV | Dragonfly | Redis 1スレッド | Redis I/Oスレッド8 | Valkey 1スレッド | Valkey I/Oスレッド8 |
|---|---|---|---|---|---|---|
| 19,584 | 0.38 / 1.81 | 0.48 / 1.90 | 1.63 / 5.29 | 0.68 / 2.07 | 1.59 / 5.13 | 0.76 / 2.63 |
| 99,552 | 0.24 / 0.76 | 0.27 / 1.76 | 2.60 / 5.12 | 0.40 / 0.98 | 2.65 / 5.13 | 1.71 / 3.19 |
| 199,920 | 0.25 / 0.59 | 0.25 / 1.34 | 2.91 / 5.60 | 0.55 / 1.11 | 3.02 / 5.81 | 1.11 / 2.15 |
| 399,840 | 0.27 / 0.63 | 0.27 / 1.48 | NS (258k) | 0.62 / 1.23 | NS (259k) | 1.24 / 1.49 |
| 799,680 | 0.28 / 0.75 | 0.28 / 1.26 | - | 0.68 / 1.18 | - | NS (670k) |
| 1,199,520 | 0.28 / 0.67 | 0.28 / 1.05 | - | NS (1,078k) | - | - |
| 1,599,360 | 0.28 / 0.64 | 0.28 / 0.71 | - | - | - | - |
| 2,399,856 | NS (2,284k) | NS (2,281k) | - | - | - | - |
混合負荷でも同じ傾向でした。HotKVのp99は毎秒20万から160万リクエストの範囲で0.54〜0.75 msで、各製品が維持できた点もGETと同じでした。詳細はすべて結果フォルダにあります。
シングルスレッドの行の読み方
816接続でのシングルスレッドのRedisとValkeyの中央値1.6〜3 msは、定常状態のレイテンシではありません。レート制限を使うと、memtier_benchmarkは816接続すべてを同じ瞬間に発火させます。シングルスレッドのサーバーは816件のバーストを1件ずつ処理しなければならず、リクエストの中央値には待ち行列での順番が含まれてしまいます。この影響を取り除くために、次の48接続のテストを行いました。
48接続
セルの意味は上と同じで、GETのみです。
| リクエスト/秒 | HotKV | Dragonfly | Redis 1スレッド | Redis I/Oスレッド8 | Valkey 1スレッド | Valkey I/Oスレッド8 |
|---|---|---|---|---|---|---|
| 9,984 | 0.14 / 0.54 | 0.14 / 0.37 | 0.21 / 0.89 | 0.17 / 0.92 | 0.21 / 0.91 | 0.20 / 0.81 |
| 49,968 | 0.10 / 0.28 | 0.11 / 0.28 | 0.21 / 0.41 | 0.13 / 0.28 | 0.21 / 0.43 | 0.21 / 0.44 |
| 99,984 | 0.09 / 0.28 | 0.10 / 0.28 | 0.20 / 0.40 | 0.13 / 0.28 | 0.20 / 0.38 | 0.19 / 0.35 |
| 199,968 | 0.08 / 0.27 | 0.08 / 0.27 | 0.20 / 0.35 | 0.10 / 0.27 | 0.21 / 0.36 | 0.11 / 0.28 |
| 300,000 | 0.08 / 0.27 | 0.08 / 0.27 | NS (231k) | 0.09 / 0.26 | NS (233k) | 0.09 / 0.26 |
pub/subの配信時間
パブリッシュからサブスクライバーへの配信までの時間を、64パブリッシャー、100サブスクライバー、128バイトのペイロードで、pubsub-sub-benchを使って測りました。各メッセージは1つのサブスクライバーに届きます。セルはp50 / p99(ミリ秒)です。
| 配信/秒 | HotKV | Dragonfly | Redis 1スレッド | Redis I/Oスレッド8 | Valkey 1スレッド | Valkey I/Oスレッド8 |
|---|---|---|---|---|---|---|
| 約 21,000 | 0.10 / 0.71 | 0.10 / 0.65 | 0.11 / 0.74 | 0.11 / 0.62 | 0.11 / 0.76 | 0.12 / 0.78 |
| 約 107,000 | 0.10 / 1.02 | 0.12 / 0.92 | 0.10 / 0.80 | 0.11 / 0.63 | 0.10 / 0.82 | 0.10 / 0.86 |
| 約 215,000 | 0.11 / 1.20 | 0.13 / 1.13 | 0.51 / 1.03 | 0.20 / 0.73 | 0.57 / 1.07 | 0.12 / 1.22 |
どの製品も同じ範囲で配信しました。最も高い負荷では、シングルスレッドの製品の中央値が高く、HotKVの0.11 msに対して0.51 msと0.57 msでした。
pubsub-sub-benchにもパッチを当てる必要がありました。このツールは、ミリ秒単位のパブリッシュ時刻とマイクロ秒単位の受信時刻を比べていました。パッチは結果フォルダにあります。
結果からわかること
表からは、高負荷ではHotKVとDragonflyが優位で、軽負荷では差がなく、シングルスレッドのRedisとValkeyには上限があることがわかります。
HotKVとDragonflyは毎秒160万リクエストまで低いテールを保った
どちらも816接続で毎秒160万GETを維持し、中央値は0.28 msでした。HotKVのp99は毎秒20万リクエスト以上で0.59〜0.76 msでした。Dragonflyは0.71〜1.48 msで、160万では両者が近づきました(0.64 msと0.71 ms)。I/Oスレッド付きのRedisとValkeyは、より低い負荷でレートを維持できなくなり、シングルスレッドのRedisとValkeyは約26万で維持できなくなりました。
軽負荷ではマルチスレッドの各製品が並ぶ
48接続、毎秒300,000リクエストまでの範囲で、HotKV、Dragonfly、I/Oスレッド8のRedisはすべてp99が約0.27 msでした。中央値はHotKVが最も低く、毎秒100,000リクエスト以上で0.08〜0.09 msで、Dragonflyは0.08〜0.10 msでした。0.01 msの差は構成の他の部分が生み得る範囲に収まるため、優位とは主張しません。
シングルスレッドのRedisとValkeyは毎秒約23万で頭打ちになった
48接続では、中央値が約0.2 ms、p99が0.35〜0.43 msで、毎秒300,000リクエストは維持できませんでした(約231,000と233,000)。このハードウェアとこの負荷での、1スレッドの上限です。だからRedisとValkeyは、多数のプロセスやクラスターとして動かすのが一般的で、クラスターのベンチマークでもそうしました。
制限事項
これは、上記のバージョンと構成についてのHotKV Ltdの測定です。これらの製品の他のバージョン、構成、負荷についての主張ではありません。
テストの構成
- サーバー1台、負荷生成マシン1台。 各段階2回の繰り返しで、1組のマシンを1つの日付に使いました。マシン間や日による変動は測っていません。
- 私たちが選んだ構成。 RedisとValkeyは既定のシングルスレッド設定と
--io-threads 8で動かし、それ以上のチューニングはしていません。他の設定では数値が変わる可能性があります。ここでの設定が特定の製品に不利だとお考えの場合は、お知らせください。確認して結果を公開します。 - ツールのバースト効果。 816接続では、
memtier_benchmarkのレート制限の仕組みにより、シングルスレッド製品の中央値が膨らんでいます。上で説明したとおりです。
測定していないこと
- データ。 より大きい値や偏った値、キーあたりのメモリ、永続化。永続化はすべてのサーバーで無効でした。
- モード。 クラスターモード、シャード化されたpub/sub、TLS、レプリケーション、フェイルオーバー。
- pub/subのファンアウト。 1つのメッセージを多数のサブスクライバーへ。
Redis、Valkey、Dragonflyはそれぞれの所有者の商標です。測定したソフトウェアを特定するためだけに名前を挙げており、後援、推奨、提携を意味するものではありません。
再現する
スイープスクリプト、各サーバーの起動コマンドとライブ設定、pubsub-sub-benchのパッチ、すべての生データはベンチマークリポジトリにあります。レイテンシ用のスクリプトはharness/lat_sweep.sh、pub/sub用はharness/ps_sweep.shです。rawフォルダには、テストごとに、memtier_benchmarkのJSON、HDRヒストグラム、各実行でのサーバーのCPU使用率をまとめたアーカイブがあります。
自分で試す
HotKV CloudがHotKVを代わりに運用します。HotKV Cloudを始めるか、営業に相談して、ご自身のワークロードでHotKVを比較してください。
よくある質問
HotKVはレイテンシでRedisより速いですか。
負荷がかかった状態で、今回試したレートでは、速いです。816接続、毎秒200,000リクエストで、HotKVのp99は0.59 ms、I/Oスレッド8のRedisは1.11 ms、シングルスレッドのRedisは5.60 msでした。48接続の軽負荷では、マルチスレッドの各製品がp99で並び、約0.27 msでした。
なぜリクエストレートを固定したのですか。
レートを固定すれば、どの製品も同じ負荷を受けるため、レイテンシを比較できます。スループットのテストは、サーバーが限界でどれだけ処理するかを示しますが、1件のリクエストがどれだけ待たされるかはほとんどわかりません。
「維持できず」とは何ですか。
製品が、要求したリクエストレートの97パーセント未満しか達成できなかったということです。memtier_benchmarkはクローズドループのツールなので、過負荷のサーバーではクライアントが送る数を減らし、残ったリクエストのレイテンシは実際より良く見えます。そのため、これらの段階ではレイテンシを示していません。
pub/subの配信時間はどうでしたか。
試した3つの負荷では、すべての製品が同じ範囲で配信し、低い方の2つの負荷では中央値が約0.1 msでした。すべての数値は上の表にあります。
このRedisレイテンシベンチマークを再現できますか。
はい。スクリプト、構成、すべての生データがベンチマークリポジトリにあります。同じネットワーク上の2台のサーバー、負荷生成マシン、4つの製品が必要です。
会話を続けましょう
コメント
手法について質問がありますか?お使いのハードウェアで異なる結果が出ましたか?わかったことをぜひ共有してください。コメントは審査後に表示されます。