
AIエージェントのメモリ:4つの種類と保存方法
AIエージェントのメモリは、長いコンテキストウィンドウとは別物です。エージェントに必要な4種類のメモリ、保存方法、保存すべきでない情報を、HotKVのコマンドで解説します。
Norbert E. Boros記事を読む AIエージェントのメモリ:4つの種類と保存方法
タグ
言語モデルを使うアプリケーションでのHotKVの活用:モデル呼び出し、トークンの集計、応答の再利用、セマンティックキャッシュにおける品質のトレードオフ。
4件の記事 「LLM」に分類
AIエージェントのメモリは、長いコンテキストウィンドウとは別物です。エージェントに必要な4種類のメモリ、保存方法、保存すべきでない情報を、HotKVのコマンドで解説します。
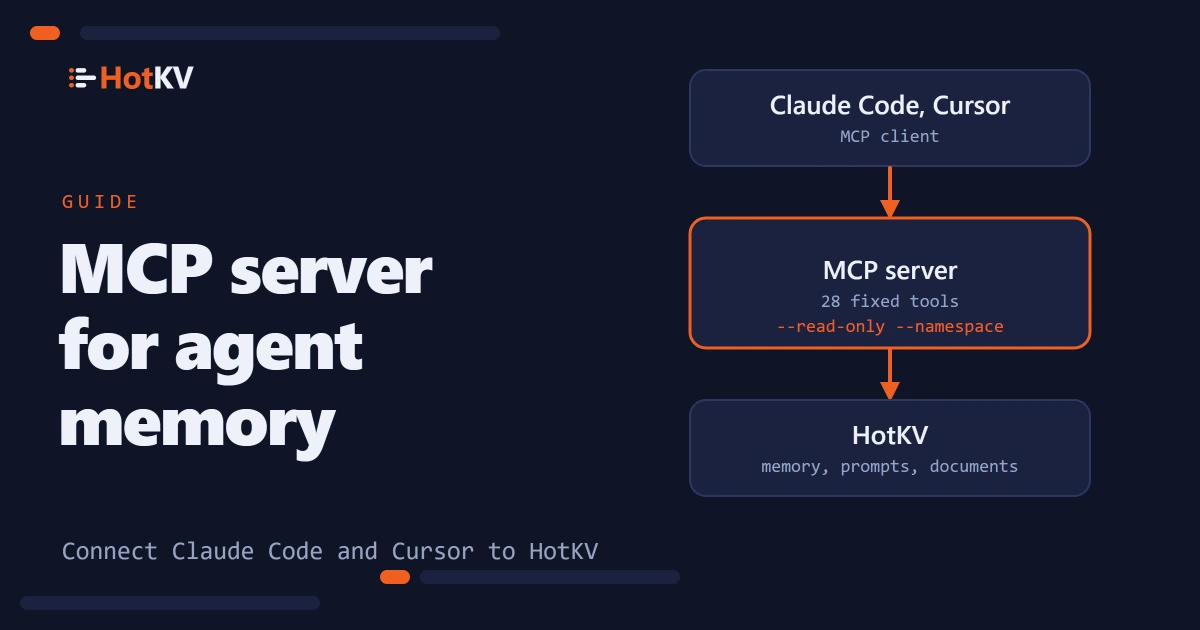
MCPサーバーを使うと、28個の固定ツールを通じてClaude CodeやCursorがHotKVのメモリを利用できます。導入、接続、読み取り専用モードと名前空間による制限を解説します。

プロンプトキャッシュは繰り返される先頭部分を安くし、セマンティックキャッシュはモデル呼び出しそのものをなくします。仕組み、実測結果、使い分けを解説します。

4つのClaudeモデルに3,000件ずつサポートリクエストを送信。HotKVのキャッシュでモデル呼び出し、トークン、APIコストを約70%削減しました。結果と回答の品質のトレードオフを紹介します。
興味の赴くままに