

言語モデル向けに「キャッシュ」として売られているものには2種類あり、片方を買ってもう片方の効果を期待してしまうチームが少なくありません。プロンプトキャッシュはモデルプロバイダーの機能で、繰り返されるプロンプトの先頭部分を安く読み取れるようにします。セマンティックキャッシュは自分で運用する層で、質問にメモリから回答することで、モデルをそもそも呼び出さないようにします。この2つは請求額の別々の部分を解決するもので、組み合わせたときに最も効果を発揮します。
要点。 プロンプトキャッシュが割り引くのは、長いシステムプロンプトのような、プロンプトの繰り返される先頭部分だけです。モデルは実行され、出力トークンはすべて課金されます。完全一致キャッシュとセマンティックキャッシュは、以前に回答済みの質問であれば、呼び出しそのものをなくします。プロバイダーのプロンプトキャッシュを有効にしたまま行った3,000件のリクエストのベンチマークでは、前段にHotKVを置くことで、モデル呼び出し、トークン、コストが約70%減りました。ベースラインのコストのうち73%から92%は、依然として出力トークンが占めていたためです。
プロンプトキャッシュの仕組み
プロンプトキャッシュはモデルプロバイダー側にあります。リクエストの変わらない先頭部分、通常はツールとシステムプロンプトに印を付けると、プロバイダーはその処理済みの状態をしばらくの間保存します。次に、まったく同じテキストで始まるリクエストが来ると、その部分は割引料金で課金されます。ここでは、実際に測定したAnthropicの方式を説明します。以下の詳細はプロンプトキャッシュのドキュメントに基づいており、2026年10月18日に確認しました。
キャッシュされる対象
ヒットするには完全一致が必要です。cache_controlで印を付けたブロックまでのすべてのブロックが、ツール、システムプロンプト、メッセージの順で同一でなければなりません。プロンプトの前の方で1文字でも変わると、それ以降はすべてミスになります。質問そのものは最後に来るため、キャッシュされる先頭部分には含まれません。
最小の長さに満たないプロンプトはキャッシュされず、エラーも返されません。私たちが使用した現行のClaudeモデル(Fable 5.1、Opus 5.5、Sonnet 5.5、Haiku 5.5)では、ドキュメントに記載された最小値は512トークンです。キャッシュのエントリは組織ごとに分離され、Claude APIではワークスペースごとにも分離されます。
コスト
デフォルトの有効期間は5分で、エントリを使うたびに追加料金なしで更新されます。1時間の有効期間も選べます。エントリの書き込みには、5分の場合は基本入力価格の1.25倍、1時間の場合は2倍かかります。読み取りは、ほとんどのモデルで基本入力価格の0.1倍、Opus 5.5とSonnet 5.5では0.05倍、Fable 5.1では0.025倍です(料金ページによる)。この倍率は変わるため、計算する前に最新のページをご確認ください。
プロンプトキャッシュでは削減できないもの
プロンプトキャッシュが割り引くのは、先頭部分の読み取りです。モデルの実行は省きません。リクエストのたびに新しい回答が生成され、その待ち時間も発生し、出力トークンはすべて出力の定価で課金されます。
私たちのベンチマークは、それがどれほど重要かを示しています。4つのClaudeモデルそれぞれに3,000件のカスタマーサポートの質問を送信し、システムプロンプトには2,200トークンのポリシーを使い、プロバイダーのキャッシュを有効にしました。集計したトークンの90%から93%は、そのポリシーのキャッシュ読み取りでした。出力はトークンのわずか6%から9%でしたが、ベースラインのコストの73%から92%を占めていました。先頭部分はすでに安くなっていたので、残りの支出は回答にあったのです。
他の層が埋めるのは、この差です。手法と結果の全体はトークン削減のベンチマークでご覧いただけます。
完全一致とセマンティックの応答キャッシュ
メモリからリクエストに回答する層は2つあります。新しいリクエストが過去のリクエストと一致するかどうかをどう判断するかが異なります。
完全一致の応答キャッシュ
完全一致キャッシュは、最終的な回答を、その内容を左右するすべての要素から作ったキーで保存します。通常は、モデル、プロンプトのバージョン、正規化した質問です。同じリクエストが再び来ると、保存された回答が返され、モデルは呼び出されません。類似度スコアはなく、別の質問向けの回答を返してしまうリスクもありません。
私たちの実行では、完全一致キャッシュがリクエストの約39%に回答しました。繰り返された質問は、中央値約0.05 msで返りました。これは同じマシン上でループバック経由のPythonクライアントを使って測定したので、ネットワーク越しではなくローカルの数値としてお読みください。ベンチマークでは、この層に通常のGETとSETを使用しました。HotKV Enterpriseには、名前空間ごとの上限とコスト追跡を備えた、完全一致のプロンプトキャッシュPCACHE.*も用意されています。
完全一致キャッシュは言い回しの違いを区別できません。「パスワードをリセットするには?」と「パスワードを忘れました」は、別々のキーになります。
セマンティックキャッシュ
セマンティックキャッシュは、質問の意味でルックアップします。質問を埋め込みに変換し、最も近い保存済みの質問を探して、コサイン類似度がしきい値を超えていれば、その回答を返します。HotKVではSCACHE.*がこれにあたり、ベクトル検索と同じベクトルインデックスの上に構築されています。
私たちのリクエストの約31%が、この方法で回答されました。言い換えた質問は中央値で約130 msかかり、そのほぼすべてが埋め込みサービスの呼び出しでした。そのため、セマンティックヒットはモデル呼び出しよりはるかに速いものの、瞬時ではありません。セマンティックレイヤーがなければ、完全一致キャッシュだけでは3,000件中最大1,264回のモデル呼び出しが必要で、削減は約58%でした。セマンティックレイヤーによって、削減は約70%まで増えました。
リスクもここにあります。似た質問が、常に同じ質問とは限りません。私たちは別のClaudeモデルに、すべてのセマンティックヒットを新規回答と照らして判定させました。デフォルトのしきい値0.81では、キャッシュ回答が質問そのものに適合する頻度は、新規回答より5.8から10.7パーセントポイント低くなりました。Sonnet 5.5では、0.88以上のしきい値でそのような差は見られませんでしたが、根拠は限られています。決定的な細部が1つだけ違うように作った質問は、0.81では62%、0.95では10%の割合で、それでも一致しました。
プロンプトキャッシュとセマンティックキャッシュの比較
| プロバイダーのプロンプトキャッシュ | 完全一致の応答キャッシュ | セマンティックキャッシュ | |
|---|---|---|---|
| 削減されるもの | 入力価格の一部 | モデル呼び出しそのもの | モデル呼び出しそのもの |
| 一致のルール | 先頭部分が同一 | リクエストが同一 | しきい値を超える意味の近さ |
| 出力トークンの課金 | あり、毎回 | なし(ヒット時) | なし(ヒット時) |
| 誤った回答のリスク | なし | 同一リクエストではなし | あり、しきい値で調整 |
| 動作する場所 | プロバイダー側 | 自分のキャッシュ内 | 自分のキャッシュ内と、埋め込みの呼び出し |
| 今回の実行でのリクエストの割合 | 常に有効 | 約39% | 約31% |
プロバイダーのプロンプトキャッシュと応答キャッシュは、どちらかを選ぶものではありません。一方は引き続き行う呼び出しの価格を下げ、もう一方は呼び出しの回数を減らします。
キャッシュがレイテンシに与える影響
モデルを省くと、コストだけでなく、回答が届く速さも変わります。今回の実行では、回答が完全に返るまでの中央値は、Fable 5.1で2.7秒から127 ms、Opus 5.5で2.9秒から126 ms、Sonnet 5.5で1.8秒から128 ms、Haiku 5.5で1.4秒から125 msに短縮されました。中央値で11倍から23倍の高速化です。
遅い側はほとんど変わりませんでした。リクエストの約30%は依然としてモデルに到達し、Fable 5.1の99パーセンタイルは、HotKVありで約6.4秒、なしで6.6秒でした。キャッシュが解消するのは、キャッシュが回答したリクエストの待ち時間であり、ミスしたリクエストには何の効果もありません。典型的なケースではなく最悪のケースが遅いことが問題なら、キャッシュだけでは解決しません。
これらは、呼び出しをストリーミングしなかったため、回答全体が返るまでの時間です。ストリーミングされた回答は、最初の言葉がもっと早く表示されます。チャット画面での差は、これらの数値の差より小さくなります。
トラフィックに合わせた層の選び方
適切な層は、リクエストがどのように繰り返されるかによって決まります。そしてそれは、何かを構築する前に測定できます。
トラフィックに層を合わせる
リクエストがどう繰り返されるかに、層を合わせましょう。
- 長く変わらないシステムプロンプトやツール一覧: プロバイダーのプロンプトキャッシュを使います。有効にする手間が少なく、回答は一切変わりません。
- 同じ質問が同じ言葉で来る場合(ボタン、テンプレート、リトライなど): 完全一致の応答キャッシュを使います。安全で高速です。
- 同じことを違う言葉で尋ねるサポート、検索、FAQのトラフィック: セマンティックキャッシュを追加し、しきい値を高く設定し、信頼する前にご自身の質問で回答の品質を確認してください。
- ユーザー、時刻、ライブデータに依存する回答: どれもキャッシュしないか、回答を変える要素をキーに含めます。
削減効果は繰り返しの多さに連動します。インテントの出現に偏りをつけず、すべて同じ確率にした場合、再実行した2つのモデルでコストは56%減少し、3,000件がすべて異なる質問の場合は38%減少しました。繰り返しや類似の質問がないワークロードでは、削減効果はありません。
まず自分のトラフィックの繰り返しを測る
何かを構築する前に、トラフィックのどれだけが繰り返しなのかを調べてください。その数値が、完全一致キャッシュを導入する価値があるかを決めます。すでにログに残している質問があれば、10分でできます。キャッシュのキーと同じ方法で各質問を正規化し、異なる質問の数を数え、トラフィックのどれだけが繰り返しだったかを確認します。
from collections import Counter

def normalise(question: str) -> str:
    return " ".join(question.lower().split())

counts = Counter(normalise(q) for q in logged_questions)
repeat_share = 1 - len(counts) / sum(counts.values())
repeat_shareは、各質問を最初に1回見た後であれば、完全一致キャッシュが回答できたはずのリクエストの割合です。私たちのテストセットでは、3,000件のリクエストに1,264件の異なる質問があったので、その値は約58%でした。ご自身の値が5%前後なら、完全一致キャッシュはほとんど役に立たず、助けになるのはセマンティックレイヤーだけです。
注意点が2つあります。キャッシュは空の状態から始まるので、初期のリクエストは必ずモデルに到達します。私たちの実行では、キャッシュから応答したリクエストの割合は、最初の1,000件で約52%、最後の1,000件で約81%でした。また、先月のトラフィックのログからわかるのは、先月のことです。人々の質問内容が変わるような機能のリリースを控えているなら、その数値は大まかな目安として扱ってください。
層を組み合わせる
リクエストは、最も安価で安全な層から最も高価な層へと順に通過させ、各層が何を節約したかを確認できるようにしてください。
ルックアップの順序
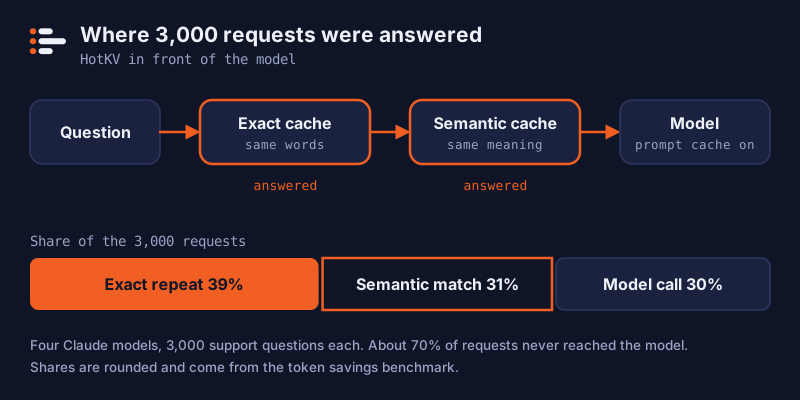
順序が重要です。最も安価で安全な層を最初に確認し、すべてミスしたときだけモデルを呼び出します。次のスケッチは、decode_responses=Trueのredis-pyスタイルのクライアント、事前に作成した2つの名前空間、そして自前のembed関数とllm関数を前提としています。
def answer(question: str) -> str:
    if hit := r.execute_command("PCACHE.GET", "answers_exact", question):
        return hit                                   # 同じ言葉

    vector = embed(question)
    hit = r.execute_command("SCACHE.GET", "answers_semantic", *vector, "THRESHOLD", 0.90)
    if hit:
        return hit[0]                                # 同じ意味

    reply = llm.complete(question)                   # ここでプロバイダーのプロンプトキャッシュが効く
    r.execute_command("PCACHE.SET", "answers_exact", question, reply, "TTL", 3600)
    r.execute_command("SCACHE.SET", "answers_semantic", question, reply, *vector, "TTL", 3600)
    return reply
名前空間は、使用する埋め込みモデルの次元数で、PCACHE.CREATE answers_exactとSCACHE.CREATE answers_semantic 1536 THRESHOLD 0.90を使って一度だけ作成します。AIコマンドセットはHotKV CloudのPerformanceプランとScaleプランのインスタンスに付属しており、各エンジンの機能はAIページにまとめています。どのプランに何が含まれるかは料金ページをご覧ください。
本番環境での効果の確認
見えないキャッシュは、信頼できないキャッシュです。HotKVは名前空間ごとにヒットとミスの回数を記録します。各エントリと一緒に元の呼び出しのトークン使用量を保存しておけば、その後のヒットごとに回避できたトークンとコストも集計できます。PCACHE.STATSとSCACHE.STATSの応答には、usage_saved_requests、usage_saved_input_tokens、usage_saved_cost_usdといったフィールドが含まれるようになります。
PCACHE.SET answers_exact "How do I reset my password?" "Open Settings ..." MODEL <model> INPUT 100 OUTPUT 180 CACHEREAD 2200
<model>は、お使いのモデルのIDに置き換えてください。INPUTはキャッシュされなかったプロンプトのトークン数、CACHEREADはプロバイダーが自身のキャッシュから提供したトークン数で、2つは重複しません。コストのフィールドが意味を持つには、そのモデルがHotKVの価格表に載っている必要があります。LLMSTATS.PRICE LISTで既知のモデルを確認でき、LLMSTATS.PRICE SETで独自のモデルを追加できます。価格のないモデルもトークンは集計されますが、コストはゼロとして記録され、価格が未設定のリクエストがあったことを別のカウンターが示します。
キャッシュは支出を減らし、予算は残りの支出に上限を設けます。LLMBUDGET.SETは、時間枠に対するトークンとドルの上限を定義します。LLMBUDGET.CONSUMEはモデルを呼び出す前に確認されるので、暴走したエージェントは、支出した後ではなく、支出する前に止められます。LLMSTATS.RECORDは、プロバイダーのキャッシュ読み取りトークンとキャッシュ書き込みトークンを理解したうえで、テナントごとの合計を保持します。3つとも、モデル名を渡せば同じ価格表を使うので、節約額、予算、ダッシュボードの数値が食い違うことはありません。
キャッシュが誤った回答を返してしまうミス
不適切なキャッシュヒットの多くは、キーに何かが欠けていることが原因です。モデル、プロンプトのバージョン、ツールやポリシーのバージョンを完全一致のキーに含めておけば、プロンプトを変更しても、古いプロンプト向けに書かれた回答が返されることはありません。
エントリの有効期間は、事実が変わる速さに合わせて設定してください。テナントごとに名前空間を分け、ある顧客の回答が別の顧客に提示されないようにします。個人データを含む回答は、そのデータが誰のものかをキーに含めない限り、キャッシュしないでください。
最後に、ご自身のトラフィックで測定してください。私たちの数値は、短い銀行関連の質問からなる1つの公開データセット、架空のポリシー、条件ごとに1回の実行から得たものであり、お使いのワークロードでの結果を約束するものではありません。
よくある質問
プロンプトキャッシュとは何ですか?
プロンプトキャッシュは、モデルプロバイダーの機能で、プロンプトの処理済みの先頭部分をしばらくの間保存します。まったく同じテキストで始まる後続のリクエストは、その部分が低い料金で課金されます。モデルは引き続き実行されて新しい回答を生成するため、出力トークンの料金は発生します。
プロンプトキャッシュはセマンティックキャッシュと同じものですか?
いいえ。プロンプトキャッシュは繰り返されるプロンプトの先頭部分を再利用しますが、モデルは呼び出します。セマンティックキャッシュは、意味の近い質問に対して保存済みの回答を返し、モデル呼び出しを省きます。対象とするコストが異なり、併用することもできます。
プロンプトキャッシュで出力トークンのコストは下がりますか?
いいえ。下がるのは、キャッシュされた先頭部分の読み取り価格だけです。私たちのベンチマークでは、プロンプトキャッシュが有効な状態で、出力はトークンの6%から9%でしたが、ベースラインのコストの73%から92%を占めていました。回答全体をキャッシュする方がはるかに大きな節約になったのは、このためです。
Anthropicのプロンプトキャッシュはどのくらい持続しますか?
デフォルトは5分で、エントリが使われるたびに更新されます。書き込み価格が高くなりますが、1時間のオプションも利用できます。制限や価格は変わるため、最新のドキュメントをご確認ください。
プロンプトキャッシュとセマンティックキャッシュは併用できますか?
はい。私たちのベンチマークがまさにそうでした。どちらの実行でもプロバイダーのプロンプトキャッシュは有効のままで、完全一致とセマンティックの層をモデルの前段に置きました。キャッシュヒットは呼び出しを省き、ミスした場合も割引された先頭部分の恩恵を受けます。
セマンティックキャッシュのしきい値はどのくらいにすべきですか?
どこでも通用する値はありません。私たちは別の訓練分割で0.81を選びました。Sonnet 5.5では、0.88以上でキャッシュ回答に新規回答と比べた品質の低下は見られませんでしたが、根拠は限られています。高い値から始め、ご自身の質問でキャッシュ回答を新規回答と比較して判定し、品質が保たれる場合にだけしきい値を下げてください。

会話を続けましょう
コメント
手法について質問がありますか?お使いのハードウェアで異なる結果が出ましたか?わかったことをぜひ共有してください。コメントは審査後に表示されます。