

AIエージェントのメモリは、エージェントがあるステップ、あるいはあるセッションから次へ情報を持ち越すための仕組みです。言語モデルは単体では、呼び出しの合間に何も覚えていません。覚えているように見えるものは、すべてコードがプロンプトに戻しているものです。その情報をどう保存し、どう取り出すかが、エージェントが何を思い出せるか、どれだけ速く思い出せるか、1ターンあたりのコストがいくらになるかを決めます。
要点。 エージェントには4種類のメモリが必要です。短い会話ウィンドウ、意味で見つける長期的な事実、進行中のタスクのためのスクラッチパッド、そして起きたことのログです。それぞれ形、有効期間、ルックアップの方法が異なるため、1つのメモリテーブルではどれにもうまく合いません。HotKVは、
AMEM.*コマンドを使い、1つのインメモリエンジンで4つすべてを保存します。私たちがベンチマークしたのはHotKVのキャッシュとベクトル検索であり、エージェントメモリではないため、この記事では設計を説明するだけで、高速化を主張することはしません。
コンテキストウィンドウがメモリではない理由
コンテキストウィンドウは、リクエストのたびに送信するテキストです。サイズに上限があり、その中身すべてに毎ターン入力トークンの料金がかかり、セッションが終わると消えます。検索することもできません。エージェントが3週間前の事実を1つ必要としているときに、履歴全体を貼り付けるのは答えになりません。
メモリは、次にウィンドウへ何を入れるかを決める層です。直近のターンを保持し、重要な数件の古い事実を見つけ出します。現在のタスクの状態を保持し、エージェントがこれまでに行ったことを記録します。研究者たちも、エージェントを同じような言葉で説明しています。Sumers、Yao、Narasimhan、GriffithsによるCoALAフレームワークは、ワーキングメモリと、長期のエピソード記憶、意味記憶、手続き記憶を区別しています。
AIエージェントのメモリの4つの種類
HotKVの4つのストアは、アプリケーションが実際に構築する必要のあるものに合わせて調整されており、同じ領域の大部分をカバーします。手続き記憶、つまりエージェントのコードやプロンプトに含まれるノウハウは、通常はリポジトリやプロンプトレジストリにあり、独立したストアにはなりません。
会話メモリ
1つのセッションの短期的な記録です。メッセージにはロール(system、user、assistant、tool)が付きます。メッセージは上限のあるスライディングウィンドウに入り、上限に達すると最も古いターンから外れます。答えるのは1つの問いです。最近何が話されたか? HotKVでは、AMEM.CONV.CREATE、AMEM.CONV.APPEND、AMEM.CONV.WINDOWがこれにあたります。
セマンティックメモリ
セマンティックメモリは、埋め込みベクトルを付けた事実として保存される長期的な知識です。エージェントは、キーではなく意味でそれらを呼び出します。ベクトル検索を支えるものと同じ種類のHNSWベクトルインデックスで支えられています。AMEM.SEM.STOREは事実を保存し、AMEM.SEM.RECALLは類似度スコア付きで上位の一致を返します。ドキュメント、ユーザーの好み、学習した訂正は、ここに属します。
ワーキングメモリ
ワーキングメモリは、進行中のタスクのためのスクラッチパッドで、セッションにスコープされたキーと値のフラットな集合です。現在のステップ、対応中のチケット、途中結果などを保持します。タスクが終わったら消えるべきものです。AMEM.WORK.SETが有効期間(TTL)を受け付けるのは、まさにそのためです。
エピソードメモリ
エピソードメモリは、実行した操作、行った観察、下した判断といった、タイムスタンプ付きのイベントを追記専用で記録するログです。エージェントや、それをレビューする人が、何がいつ起きたかを問い合わせられるようにします。AMEM.EPIS.LOGはイベントを書き込み、AMEM.EPIS.QUERYは種類と時間範囲でそれらを読み出します。
実践でのAIエージェントのメモリ
実践で重要なのは2点です。メモリへどう書き込むか、そして各ターンで何を読み戻すかです。
コマンドでメモリを保存する
ここでは、1つの会話に対応するサポートエージェントを例にします。架空のポリシーのテキストと3つの数値のベクトルは、説明のためだけのものです。実際の埋め込みモデルは768個や1,536個の数値からなるベクトルを生成し、名前空間はその次元数で作成します。
AMEM.CONV.CREATE session-42 WINDOW 50 TTL 86400
AMEM.CONV.APPEND session-42 user "My invoice shows the wrong VAT number."
AMEM.WORK.SET session-42 ticket "INV-1932" TTL 3600
AMEM.EPIS.LOG agent-support action "Looked up invoice INV-1932"

AMEM.SEM.CREATE support-kb 3
AMEM.SEM.STORE support-kb vat-policy "VAT details can be corrected within 30 days." 0.1 0.2 0.3
AMEM.SEM.RECALL support-kb 3 0.1 0.2 0.3
AMEM.CONV.WINDOW session-42 10
エージェントは各ターンで、直近のウィンドウを読み、質問に合う数件の事実を呼び出します。作業メモを確認し、それらの断片からプロンプトを組み立てます。行動した後は、そのイベントを記録します。このループに履歴全体は必要ありません。
毎ターンのメモリの読み取り
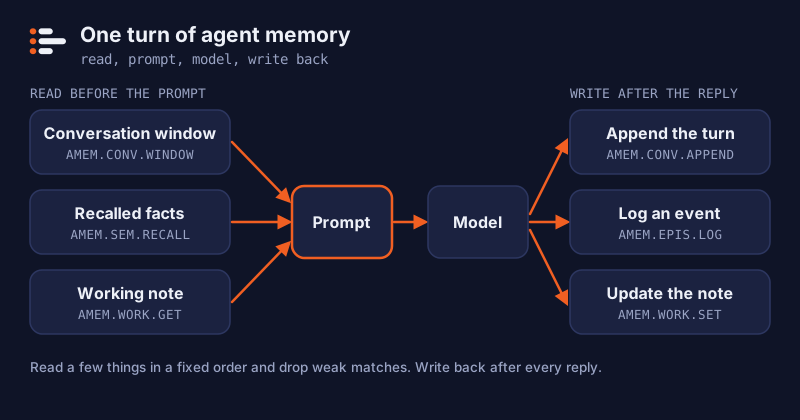
メモリの保存は簡単な方です。腕の見せどころは、何を読み戻すかを決めることです。読んだものはすべてプロンプトに入り、入力トークンのコストがかかるからです。妥当なループでは、少数のものを決まった順序で読みます。まず直近のターン、次に質問に合う数件の事実、最後にタスクの状態です。以下は公式のPythonクライアントを使った例で、埋め込み関数とプロンプトテンプレートはご自身のものを使います。
import hotkv

r = hotkv.from_url("hotkv://localhost:6379")
MIN_SIMILARITY = 0.8          # ご自身のデータで調整する

def start_session(session: str) -> None:
    r.amem_conv_create(session, window=50, ttl=86400)   # 最初の追記の前に一度だけ作成する

def build_context(session: str, question: str) -> str:
    r.amem_conv_append(session, "user", question)
    turns = r.amem_conv_window(session, 10)
    facts = r.amem_sem_recall("support-kb", 3, embed(question))
    facts = [f for f in facts if f["similarity"] >= MIN_SIMILARITY]
    ticket = r.amem_work_get(session, "ticket")
    return render(turns, facts, ticket)      # ご自身のプロンプトテンプレート

def finish_turn(session: str, agent: str, reply: str) -> None:
    r.amem_conv_append(session, "assistant", reply)
    r.amem_epis_log(agent, "action", "Answered a billing question")
    r.amem_work_set(session, "last_step", "answered")
類似度の足切り値は、ご自身で調整するものです。ある埋め込みモデルと事実の集合に合う値は、別のものには合いません。答えがわかっている質問で、再現率を確認してください。弱い一致を除外することは、見た目以上に重要です。質の低い事実がプロンプトに入るくらいなら、事実がない方がましだからです。
このプロンプトの変わらない部分、たとえばシステム指示は、プロバイダー側のプロンプトキャッシュで安くなる部分でもあります。読み取ったメモリは、変わらないテキストの後ろ、末尾に置いてください。そうすれば、メモリが変わってもそのキャッシュは無効になりません。
ウィンドウを延ばし続けるより要約を使う
ウィンドウは、古いターンを完全に捨てます。雑談ならそれで構いませんが、3ターン目の内容が300ターン目でも重要になりうる長いタスクには向きません。通常の対処は、ローリング要約です。会話のある区間が終わるたびに、エージェント自身か、より安価なモデルが学んだことを書き留め、その要約がプロンプト内の古いターンに置き換わります。
HotKVは、AMEM.SUMMARY.SET、AMEM.SUMMARY.APPEND、AMEM.SUMMARY.GETで、エージェントごとに1つの要約を保持します。SETはテキストを置き換え、APPENDは1行を追加します。更新のたびにバージョン番号が上がるので、ほかのコンポーネントは、要約が変わったこととそのタイミングを低コストで判断できます。
要約は不可逆で、要約の要約を重ねるたびに失われるものが増えます。識別子、金額、日付といった正確な値は、文章の中ではなく、ワーキングメモリやセマンティックな事実に置いてください。そこなら残ります。要約は、好み、下した判断、残っている作業といった、作業の全体像のために使います。
設計ルールと保持期間
メモリは、止めない限り際限なく増えます。最初の書き込みの前に、上限を決めてください。
メモリを使えるものに保つルール
- すべてに上限を設ける。 会話には
WINDOWを、セッションとワーキングの値にはTTLを設定します。会話、ワーキングの値、事実については、HotKVが追記専用ファイルとレプリカのために有効期限を記録するので、期限切れのエントリが、再起動後にファイルが再生されても復活することはありません。 - 記録ではなく事実を保存する。 セマンティックメモリに書き込む前に要約します。対話の1ページより、1つの事実の方が呼び出しやすくなります。
- エージェントを分離する。 エージェントごと、テナントごとに別々の識別子や名前空間を使い、ある顧客のメモリが別の顧客のために呼び出されることがないようにします。
- 多くではなく少数を呼び出す。 上位3件から5件の一致だけを取り、弱いものはプロンプトに入る前に類似度スコアで除外します。
- 機密情報を入れない。 メモリはプロンプトに読み戻されるので、パスワード、キー、モデルに見せたくないデータは、決して保存しないでください。
種類ごとの保持期間
これらの期間は私たちの提案であり、デフォルトではありません。基になる事実が変わる速さと、保持を許される範囲から、ご自身の期間を決めてください。
| メモリの種類 | 推奨する期間 | HotKVでの制御 |
|---|---|---|
| 会話 | セッションの間、または1日のような一定期間 | AMEM.CONV.CREATEのWINDOWとTTL |
| ワーキング | タスクの間。その後は消去 | AMEM.WORK.SETのTTLと、AMEM.WORK.CLEAR |
| セマンティック | その事実が正しくなくなるまで | AMEM.SEM.STOREのTTLと、AMEM.SEM.FORGET |
| エピソード | 監査やサポートの要件が求める期間 | 時間範囲を指定するAMEM.EPIS.QUERYと、AMEM.EPIS.CLEAR(イベントには有効期間がありません) |
保持期間は、プライバシーの問題でもあります。メモリに人物に関する情報が含まれる場合、選んだ期間はその人に約束する内容の一部になるので、文書にして残してください。
エージェントメモリが失敗するパターン
メモリのバグの多くは、ゆっくり現れます。エージェントは1週間はうまく動き、その後だんだん悪くなっていきます。設計で備えておくべき失敗は次のとおりです。
よくある失敗
- 古くなった事実。 3月には正しかった事実が10月に呼び出されます。事実に有効期間を設けるか、エンティティごとのキーで保存して、新しい値が古い値を上書きするようにします。
- 矛盾。 保存された2つの事実が食い違い、エージェントがどちらかを無作為に選びます。古いメモの隣に新しいメモを追記するより、キーごとに1つの事実にする方が適切です。
- 過剰な呼び出し。 一致が多すぎて、プロンプトが関連の薄いテキストで埋まります。少数だけを呼び出し、弱い一致は除外します。
- ユーザー間の漏えい。 ある顧客のメモリが別の顧客のために呼び出されます。テナントごとに識別子や名前空間を分け、読み取りのたびにコードで確認します。
- 際限のない増加。 何も期限切れにならず、ルックアップが遅くなり、コストがじわじわ増えます。すべての種類に有効期間が必要です。エピソードログのように、HotKVに有効期間がない場合は、消去またはエクスポートを自分でスケジュールしてください。
- 要約のドリフト。 要約の要約は、次第に実際に起きたこととずれていきます。イベントログを信頼できる情報源として保ち、要約はそこから再生成してください。
保存されたテキストを信頼しない
最後の点は、もっと注意が必要です。エージェントがメモリに書き込んだものは、後からプロンプトに読み込まれる可能性があります。Webページ、メール、ユーザーから来たテキストも含みます。これは、OWASPがLLM01として挙げているプロンプトインジェクションの間接的な形態です。事実ごとに情報源を保存してください。外部のコンテンツから書き込まれたメモリは信頼度を下げ、呼び出されたメモがシステムプロンプトを上書きすることは決して許さないでください。
測定したことと、していないこと
HotKVが公開しているベンチマークは、コマンドのスループット、ベクトル検索、応答キャッシュによるトークン削減を対象としています。エージェントメモリには、まだ独自のベンチマークがありません。そのレイテンシや、エージェントの品質がどれだけ向上するかについて、私たちは何も主張しません。言えるのはアーキテクチャのことです。4つのストアは、キャッシュやベクトルインデックスと同じプロセスで動作します。メモリのルックアップは、すでに運用しているシステムへの1回の呼び出しです。
測定した側面は、トークン削減のベンチマークと、プロンプトキャッシュとセマンティックキャッシュの比較でご覧いただけます。エージェントメモリのユースケースでは、完全なシナリオでコマンドを紹介しています。
Claude CodeやCursorからエージェントメモリを使う
Model Context Protocolに対応したアシスタントは、独自のコードなしで、このメモリの一部を使えます。オープンソースのhotkv-mcpサーバーは、会話メモリ、作業メモ、イベントログ、ローリング要約をツールとして公開します。読み取り専用モードがあり、エージェントを閉じ込める名前空間も備えています。セマンティックメモリは公開しておらず、ツールからウィンドウやTTLを設定することはできないため、それらにはクライアントライブラリを使ってください。次の記事エージェントメモリのためのMCPサーバーで、接続方法と、そのセーフガードがカバーする範囲を紹介します。
よくある質問
AIエージェントのメモリとは何ですか?
AIエージェントのメモリは、エージェントがステップやセッションをまたいで情報を保持できるようにする、保存と取り出しの層です。通常は、直近の会話ウィンドウ、意味で見つける長期的な事実、現在のタスクのためのスクラッチパッド、イベントログを組み合わせます。
エージェントの短期メモリと長期メモリの違いは何ですか?
短期メモリは、直近のターンやタスクの状態のように、今起きていることを保持するもので、上限があり一時的です。長期メモリは、事実、好み、過去のイベントのように、セッションより長く残すべき知識を保持するもので、必要なときに検索されます。
エージェントメモリにおけるローリング要約とは何ですか?
ローリング要約は、エージェントがこれまでに学んだことや決めたことを、作業の進行に合わせて更新していく短い説明です。プロンプト内の古いターンに置き換わるので、プロンプトが増え続けることがありません。HotKVはエージェントごとに1つを保存し、更新のたびにバージョン番号を上げます。
エージェントメモリにベクトルデータベースは必要ですか?
必要なのは、事実を意味で見つけるセマンティックメモリだけです。会話ウィンドウ、ワーキング状態、イベントログにベクトルは不要です。HotKVは4つすべてを1つのエンジンに保持するので、ベクトルインデックスとその他のストアが別々のシステムになることはありません。
エージェントメモリはどのくらいの期間保持すべきですか?
種類によります。ワーキングメモリはタスクが終わったときに、会話はセッションの終了後または一定期間の後に、エピソードログは監査が求める期間にわたって、それぞれ期限切れにするべきです。セマンティックメモリの事実は、正しくなくなったら見直して削除してください。
エージェントメモリは攻撃される可能性がありますか?
はい。メモリに書き込まれたテキストは後でプロンプトに読み込まれるので、汚染されたメモがエージェントを誘導する可能性があります。各事実の出どころを記録し、外部のコンテンツへの信頼度を下げ、呼び出されたメモリの権限をシステムプロンプトより下に保ってください。
HotKVはエージェントメモリをRAMに保存しますか?
HotKVはインメモリエンジンなので、読み取りはメモリから提供されます。製品ドキュメントによると、4つのストアへの書き込みは、追記専用ファイルとレプリカのために記録され、有効期限も引き継がれます。

会話を続けましょう
コメント
手法について質問がありますか?お使いのハードウェアで異なる結果が出ましたか?わかったことをぜひ共有してください。コメントは審査後に表示されます。